Blog — Principi matematiciDante Noguez |
Versione | 0.5.0 | |
|---|---|---|---|
| Lingua | ES/EN | ||
Questo testo è ispirato a micrograd di Andrej Karpathy. Di seguito, costruiremo una rete neurale da zero, spiegando in dettaglio ciascuno dei suoi elementi.
Le reti neurali sono gigantesche funzioni matematiche. La caratteristica distintiva di queste funzioni, che catalizzano gran parte di ciò che oggi si denomina «intelligenza artificiale» (sebbene, più rigorosamente, dovremmo parlare di «apprendimento profondo» o deep learning), è che possono «apprendere» a raffinare, ottimizzare e generalizzare le «regole» (parametri) che le compongono. Tale processo di apprendimento consiste nell’iterazione di operazioni matematiche proprie del calcolo differenziale e vettoriale. Per questo, per poter formulare una rete neurale, procureremo prima di comprendere intuitivamente la derivata: quel midollo matematico dell’apprendimento.
A tale scopo, costruiremo la derivata da zero, utilizzando appena alcune nozioni basilari di geometria.
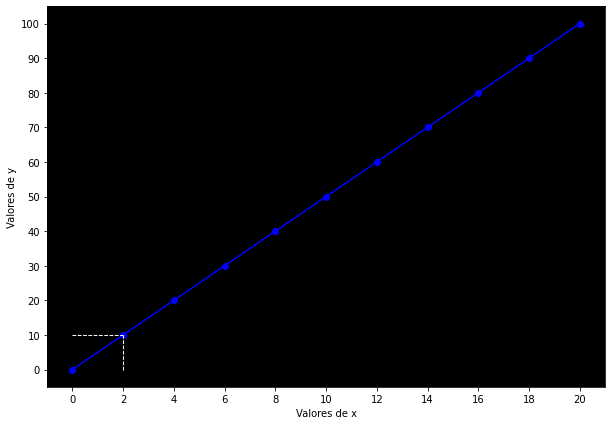
In geometria, denominiamo «pendenza» il valore dell’inclinazione di una retta. Concettualmente, la pendenza può essere interpretata come la proporzione del cambiamento che c’è tra le variabili x e y della retta. In altre parole, la pendenza misura quanto x influisce sul valore di y, o quanto cambia y quando avanziamo in x. Supponiamo, per esempio, la retta di una funzione che possiamo definire come f(x, b) = x \cdot b, dove:
x = np.arange(0, 21, 2)
b = 5
def f(x, b): return x*b
y = f(x, b)In termini più semplici, la funzione è una moltiplicazione tra x (numeri da 0 a 20 a intervalli di 2) e b (cioè 5).
Ora, come posso sapere quanto sta influendo ogni valore di x su ogni valore di y? Cioè, se passo da x=2 a x=4, cosa succede a y? y avanza da 10 a 20, ovvero cinque volte x: 5 \times 2 = 10. E se passo da x=4 a x=6, cioè se avanzo di due «passi» in x, y nuovamente avanza cinque volte quanto ho avanzato in x, passando da 20 a 30.
In tal senso, la proporzione che c’è tra x e y è 5, 5 è il numero che determina ogni valore di y a partire da x o, detto in altro modo, 5 è la «forza» con cui x influisce su y. Questa intuizione è fondamentale, ma allo stesso tempo risulta evidente perché la definizione della mia funzione (ovvero ogni valore di y) indica che devo moltiplicare x per 5. Quando calcoliamo la pendenza, è come se non conoscessimo questo numero e dovessimo dedurlo matematicamente.
La formula della pendenza ci offre un metodo generale per calcolare questa proporzione o forza di cui parliamo1:
Pendiente = \frac{y_2 - y_1}{x_2 - x_1} = \frac{\Delta y}{\Delta x}
Allora la formula ci dice semplicemente che dobbiamo prendere due punti qualsiasi di x e y per calcolare la pendenza. Per esempio, se consideriamo i valori del punto denotato dalle linee tratteggiate nel grafico precedente, in modo tale che x_1 = 2, y_1 = 10, possiamo prendere il punto successivo per calcolare la pendenza o inclinazione della retta, cosicché:
Pendiente = \frac{20 - 10}{4 - 2} = \frac{10}{2} = 5
Ma le funzioni lineari (cioè le rette), per definizione hanno la stessa inclinazione in tutti i loro punti o segmenti. Verifichiamolo cambiando le nostre x_2, y_2:
Pendiente = \frac{y_2 - y_1}{x_2 - x_1} = \frac{60 - 10}{12 - 2} = \frac{50}{10} = 5
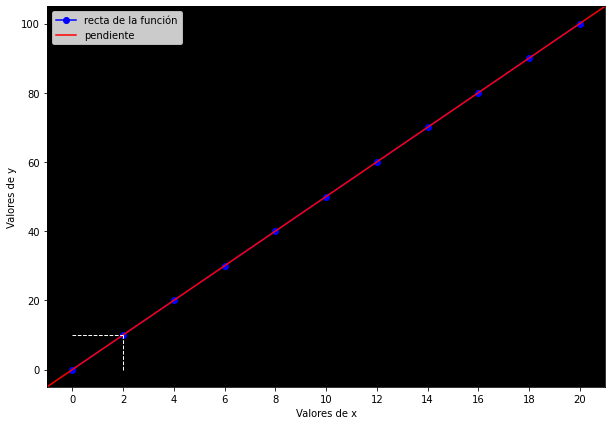
Naturalmente, la pendenza rimane la stessa. Ora ripetiamo: cosa significa esattamente il numero cinque? Che per ogni passo che facciamo in x, y avanza cinque volte di più. Detto in altro modo, y è il risultato della moltiplicazione di x per cinque; oppure x influisce con una «forza» di cinque volte se stessa su y; oppure x trasforma y con una forza di cinque volte se stessa.
La pendenza è identica alla retta perché, come dicevamo, la retta ha la stessa inclinazione (pendenza) in tutti i suoi punti. Ora, il problema con la pendenza è che questa proprietà è al tempo stesso una limitazione fondamentale: la pendenza è valida solo per una retta o funzione lineare.
Dato che le funzioni non lineari non hanno la stessa inclinazione in tutti i loro punti, non possiamo parlare dell’«inclinazione» né della «pendenza di una funzione non lineare». Visualizziamolo con una funzione quadratica, dove i miei valori di x ora vanno da 0 a 5.99. Diciamo anche che mi interessa conoscere l’inclinazione o «pendenza» della funzione quando x=5:
x = np.arange(0, 6, 0.0001)
def nolineal(x): return x**2
y = nolineal(x)

pendiente = (5**2 - 2**2) / (5 - 2)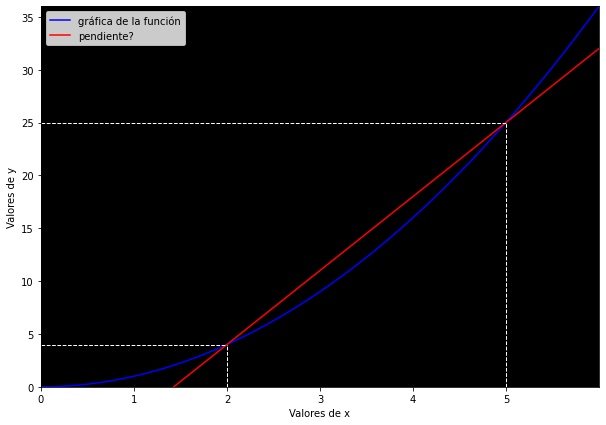
Per calcolare l’inclinazione della funzione (cioè la curva blu) quando x=5, ho utilizzato la formula della pendenza prendendo come riferimento i punti x_1=2, x_2=5, in modo tale che:
Pendiente = \frac{y_2 - y_1}{x_2 - x_1} = \frac{25 - 4}{5 - 2} = \frac{21}{3} = 7
Ma la realtà è che la mia funzione non è cambiata in quella proporzione rispetto al punto x=5: quella pendenza di 7 corrisponde alla secante2 che attraversa la funzione, non alla «pendenza» del punto x=5. Il grafico evidenzia che il risultato è inesatto: è chiaro che la funzione ha un’inclinazione diversa da quella della retta rossa3.
Oltre al fatto che la funzione ha molteplici «pendenze» (perché la sua inclinazione cambia sempre), queste «pendenze» sono inesatte, poiché non misurano con precisione l’impatto (o inclinazione) di un singolo punto nella funzione, bensì la formula della pendenza ci offre necessariamente l’inclinazione di una retta tracciata tra due valori di x e due valori di y. Poiché la funzione con cui abbiamo a che fare ora è curva, i punti di x e y che prendiamo non sono soddisfacenti perché denotano una linea, non una curva. In tal senso, il risultato è distorto.
Allora, come posso fare per trovare il vero impatto di x su y? Possiamo pensare al seguente trucco: se la pendenza della secante, sebbene erronea, si avvicina in qualche modo al nostro valore desiderato, non potremmo forse fare una secante più piccola, tale da essere più simile al punto che ci interessa? Cioè, se prendessimo la pendenza della distanza tra due punti di x più vicini tra loro, questo dovrebbe darci una migliore approssimazione al risultato corretto, no?
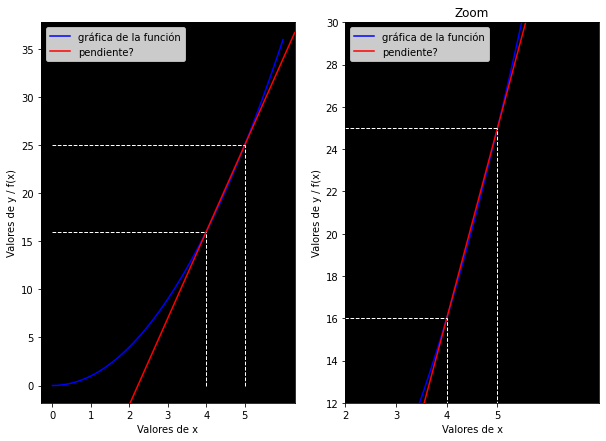
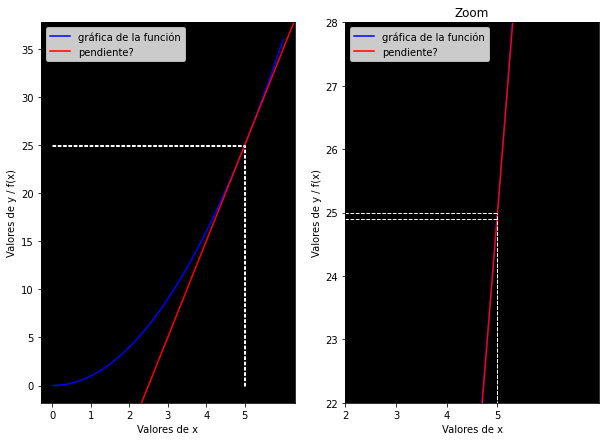
Graficamente possiamo verificare che abbiamo ottenuto un risultato molto migliore: la secante che abbiamo tracciato ha un’inclinazione simile a quella della curva della funzione. Ma le linee tratteggiate (le quali denotano i punti che abbiamo preso come riferimento per calcolare la pendenza) ci indicano che possiamo ancora migliorare, prendendo come riferimento coordinate più vicine tra loro.
Bene, dunque prima di continuare a sperimentare, anticipiamo già che questa linea di ragionamento è precisamente quella che diede origine alla derivata. Il trucco è questo: possiamo calcolare la pendenza di linee secanti sempre più piccole e simili al nostro punto, ottenendo risultati sempre migliori. Anzi, possiamo arrivare a calcolare la pendenza di una linea infinitamente piccola, così piccola da essere quasi identica al punto, e la pendenza di quella linea infinitamente piccola sarebbe uguale alla pendenza del punto. In quello stesso senso, potremmo dire persino (e in effetti si fa così in ambito matematico) che stiamo calcolando la pendenza di una linea tangente al punto, poiché la sua pendenza sarebbe uguale a quella di una secante infinitamente piccola che si confonde con il punto4.
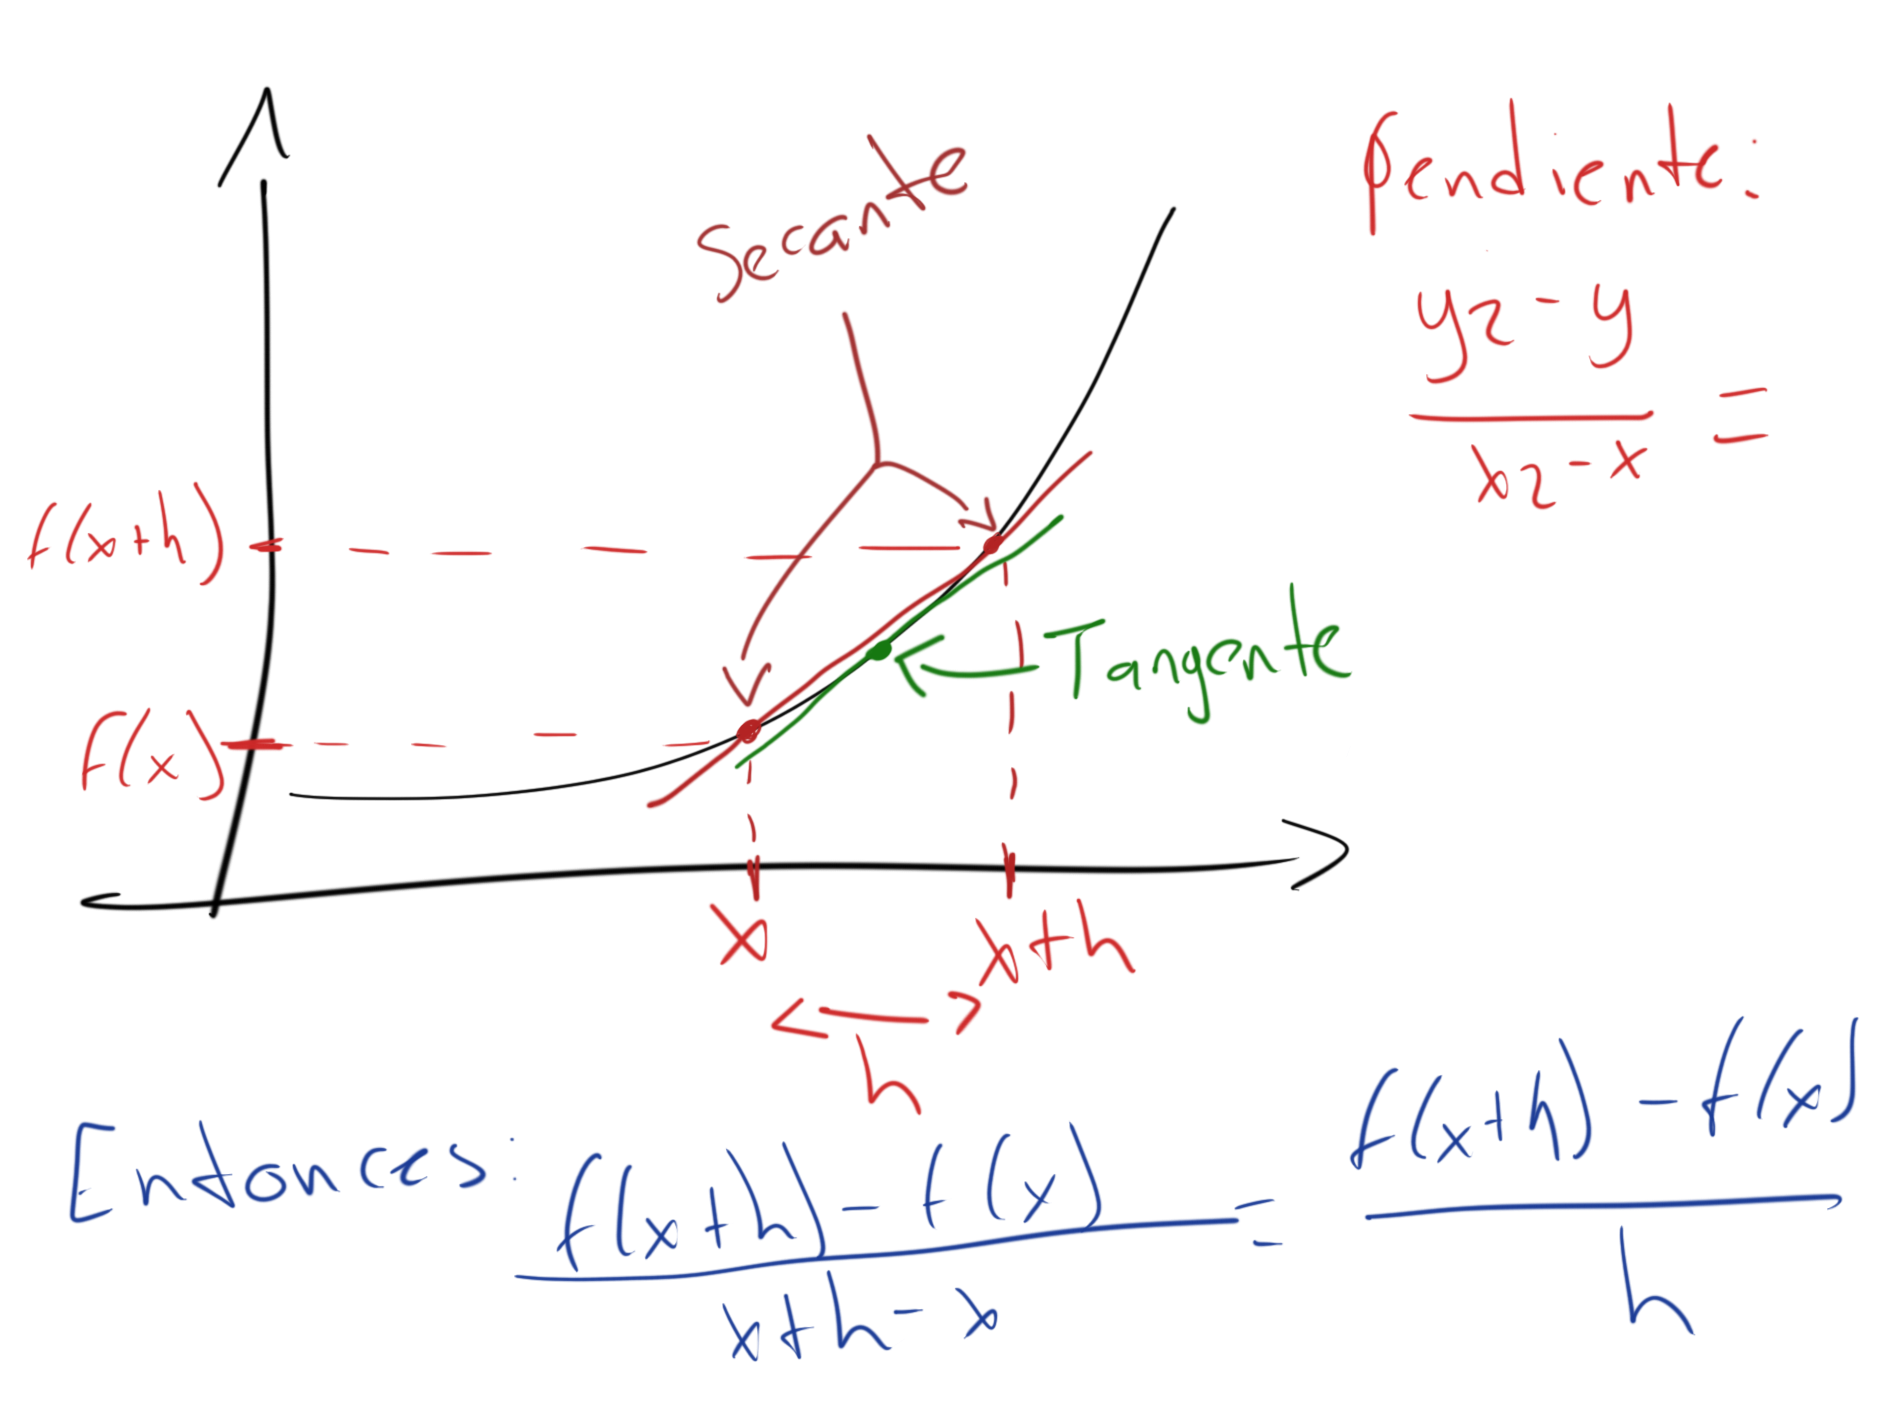
Utilizzando la formula della pendenza per mettere in pratica la nostra intuizione:
Pendiente = \frac{y_2 - y_1}{x_2 - x_1} = \frac{f(x+h) - f(x)}{(x+h) - x} = \frac{f(x+h) - f(x)}{h}
Come dicevo, idealmente vogliamo che la distanza h sia la più piccola possibile, cioè la più vicina a 0 possibile (senza essere 0, poiché abbiamo bisogno di una distanza tra due x per avere una linea e così essere in grado di ottenerne la pendenza, dato che un punto non ha pendenza). Per esprimere questa idea, utilizzeremo l’espressione \lim _{h \rightarrow 0}, cioè «quando h è così piccola da avvicinarsi a 0» o, più rigorosamente, «il limite della funzione quando h tende a 0». In modo tale che:
\lim _{h \rightarrow 0} \frac{f(x+h) - f(x)}{h}
Ma ora non stiamo parlando esattamente di una pendenza, bensì la stiamo alterando per conseguire un risultato diverso5. A questo nuovo concetto lo denomineremo «derivata»:
Derivada = \lim _{h \rightarrow 0} \frac{f(x+h) - f(x)}{h}
Nella pratica si scrive anche come \frac{dy}{dx}, o f'(x)6.
Applicata al nostro problema, possiamo utilizzarla così:
\frac{dy}{dx} =\lim _{h \rightarrow 0} \frac{f(x+h) - f(x)}{h} = \frac{(5+0.001)^2 - 5^2}{0.001} = 10.00
Programmaticamente:
def derivada(f, x):
  h = 0.001
  return (f(x+h) - f(x)) / h

derivada(nolineal, 5)
~ 10.001000000002591
Finalmente abbiamo scoperto che quando x=5, x «influisce» su y con una «forza» di 107. Analiticamente, possiamo verificarlo in questo modo:
\begin{gather*} \frac{dy}{dx} =\lim _{h \rightarrow 0} \frac{(x+h)^2 - x^2}{h} = \lim _{h \rightarrow 0} \frac{(x+h)(x+h) - x^2}{h} = \lim _{h \rightarrow 0} \frac{x^2 + xh + hx + h^2 - x^2}{h} \\ = \lim _{h \rightarrow 0} \frac{2xh + h^2}{h} = \lim _{h \rightarrow 0} \frac{h(2x + h)}{h} = \lim _{h \rightarrow 0} (2x + h) = 2x + 0 = 2x \end{gather*}
Ora, possiamo generalizzare questa espressione sotto la formula nx^{n-1}, cioè quando f(x) = x^2 e x=5, allora:
\begin{gather*} 2x = 2(5) = 10 \\ nx^{n-1} = 2(5)^{2-1} = 10 \end{gather*}
In sintesi, 10 è effettivamente la proporzione o forza con cui x influisce su y, 10 è la derivata di y rispetto a x quando x=5. E, come abbiamo visto, possiamo ottenere questo risultato in modi diversi: applicando la formula, programmaticamente, geometricamente e analiticamente o algebricamente. In generale, ogni formula o espressione matematica ha un fondamento razionale come quelli che abbiamo sviluppato, sebbene nella maggior parte dei casi siano necessari alcuni sviluppi logico-matematici ulteriori per generalizzarle.
Tornando al nostro argomento, possiamo concludere che, concettualmente, la derivata (come la pendenza) misura la proporzione o magnitudine del cambiamento che una variabile provoca nel risultato di una funzione. Diciamo che la derivata misura la forza con cui una variabile influisce (in un determinato punto) sul risultato di una funzione8.
Immaginiamo di avere due variabili: x = -2 e y = 3. La funzione f(x, y) le moltiplica e il suo risultato è -6. Tuttavia, vogliamo alterare quel risultato affinché sia 0 e abbiamo una restrizione: l’unico modo per farlo è attraverso le variabili di ingresso9.
Se ricordiamo la lezione appresa sulle derivate, ci può venire in mente di utilizzarle per risolvere questo problema: dato che la derivata mi dice l’impatto che ha una variabile di ingresso sulla funzione, sarà possibile utilizzarla per alterare il risultato della funzione? Cioè, se la derivata mi dice la magnitudine dell’impatto che una variabile ha sul risultato, allora dovrei poter utilizzare quell’informazione per influire sul risultato in modo più efficiente.
Per comprendere meglio la possibile soluzione proposta, creeremo programmaticamente la classe Numero, cioè formuleremo una struttura che ci permetta di definire, modificare e operare con numeri. Per il momento, ogni Numero avrà le seguenti proprietà: un valore, una coppia di valori precedenti nel caso in cui il valore sia stato generato mediante un’operazione (per esempio, 2 e 2 nel caso in cui moltiplicati abbiano generato il numero 4), l’operazione che ha generato detto valore (nel nostro esempio, la moltiplicazione) e un’etichetta nel caso in cui vogliamo associare il nostro valore a una variabile. Per ora, disporremo unicamente delle operazioni di somma, moltiplicazione, sottrazione e divisione:
class Numero:
  def __init__(self, valor, _previos=(), _op='', etiqueta=''):
    self.valor = valor
    self._previos = set(_previos)
    self._op = _op
    self.etiqueta = etiqueta

  def __add__(self, otro):
    otro = otro if isinstance(otro, Numero) else Numero(otro)
    resultado = Numero(self.valor + otro.valor, (self, otro), '+')
    return resultado

  def __mul__(self, otro):
    otro = otro if isinstance(otro, Numero) else Numero(otro)
    resultado = Numero(self.valor * otro.valor, (self, otro), '*')
    return resultado

  def __sub__(self, otro):
    return self + (-otro)

  def __truediv__(self, otro):
    return self * otro**-1

  def __neg__(self):
    return self * -1

  def __repr__(self):
    return f'Valor={self.valor}'
Utilizzeremo un problema più impegnativo di una semplice moltiplicazione:
a = Numero(-2.0, etiqueta='a')
b = Numero(3.0, etiqueta='b')
c = a*b; c.etiqueta = 'c'
d = Numero(10.0, etiqueta='d')
e = c + d; e.etiqueta = 'e'
f = Numero(-3.0); f.etiqueta = 'f'
L = f * e; L.etiqueta= 'L'
Possiamo visualizzare questo grafo computazionale:
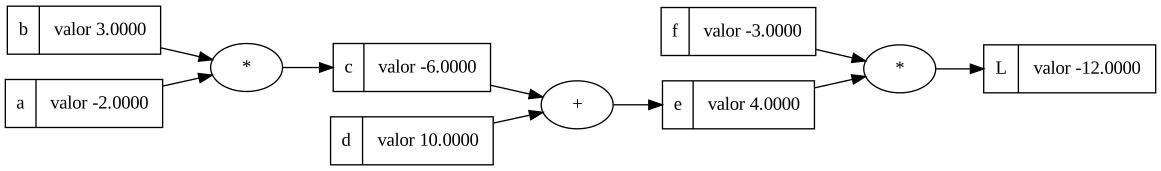
Come dicevamo, intuitivamente crediamo che la derivata possa aiutarci: con la derivata sappiamo che impatto ha ogni variabile sul risultato finale L. In tal senso, ciò che dovremo fare prima è calcolare la derivata di L rispetto a ciascuna variabile10.
In principio, la derivata di L rispetto a se stessa è 1: sebbene suoni assurdo ed evidente al tempo stesso, il cambiamento in L è proporzionale (identico) a se stesso. Ora, la derivata di L rispetto a f e e la possiamo scoprire con la formula che venivamo utilizzando:
def derivada():
  h = 0.000001
  # Función original
  a = Numero(-2.0, etiqueta='a')
  b = Numero(3.0, etiqueta='b')
  c = a*b; c.etiqueta = 'c'
  d = Numero(10.0, etiqueta='d')
  e = c + d; e.etiqueta = 'e'
  f = Numero(-3.0); f.etiqueta = 'f'
  L1 = f * e

  # Función con incremento h
  a = Numero(-2.0, etiqueta='a')
  b = Numero(3.0, etiqueta='b')
  c = a*b; c.etiqueta = 'c'
  d = Numero(10.0, etiqueta='d')
  e = c + d; e.etiqueta = 'e'
  e.valor += h
  f = Numero(-3.0); f.etiqueta = 'f'
  L2 = f * e

  print((L2 - L1) / h)

derivada()
~ Valor=-3.0La derivata della funzione L rispetto a e è approssimativamente -3. A questo punto, avremo già notato un pattern: quando deriviamo una moltiplicazione, la derivata parziale rispetto al moltiplicando è il moltiplicatore. In questo caso, L è il risultato di moltiplicare e per f. Abbiamo visto che la derivata rispetto a e è -3, ossia f. Possiamo indurre, empiricamente e per simmetria, che la derivata rispetto a f è e, ossia 4.
Forse è anche una buona opportunità per dimostrare analiticamente ciò che veniamo dicendo. Utilizzando la nostra formula matematica, abbiamo che:
\frac{\partial L(e, f)}{\partial e}=\lim _{h \rightarrow 0}{\frac{L(e + h, f)-L(e, f)}{h}} = {\frac{(e + h) \cdot f - e \cdot f}{h}} = {\frac{ef + hf - ef}{h}} = {\frac{hf}{h}} = f
E sebbene la notazione sembri complessa, in realtà stiamo solo sommando, moltiplicando, sottraendo e dividendo.
Ora che abbiamo questa informazione, vogliamo continuare al nodo precedente: le derivate rispetto a c e d. Ma qui c’è una sottigliezza che, ben compresa, ci darà la chiave delle reti neurali: dobbiamo ottenere la derivata di L rispetto a c e d, non la derivata di e rispetto ad esse. Allora, come possiamo scoprire l’impatto che c e d hanno su L attraverso e? Per fare questo calcolo basta un’intuizione piuttosto semplice11.
Prendiamo in prestito l’analogia di George Simmons: se una bicicletta è due volte più veloce di una persona che corre, e un’automobile quattro volte più veloce di una bicicletta, allora l’automobile è 2 \times 4 = 8 volte più veloce di una persona che corre.
Allo stesso modo, se vogliamo conoscere l’influenza che c ha su L, dobbiamo solo ottenere la derivata di e rispetto a c, e moltiplicarla per la derivata di L rispetto a e. Cioè, dobbiamo moltiplicare la forza di c su e e quella di e su L per sapere con quanta forza c influisce su L. Lo stesso vale per d e tutte le altre; questa regola si chiama «regola della catena» (e mediante essa si realizza la «propagazione all’indietro» nel campo dell’intelligenza artificiale).
Ora, per ottenere la derivata di e rispetto a c, ricordiamo un altro pattern che abbiamo visto: in una somma, la derivata ci dava come risultato 1 perché la funzione avanzava nella stessa proporzione in cui avanzava la variabile. Verifichiamolo:
def deriv_e(c, d):
  return (((c+0.00001)+d) - (c+d)) / 0.00001

deriv_e(-6, 10)
~ 1.0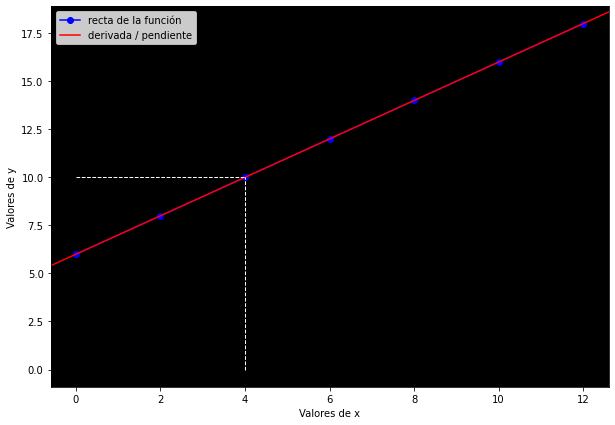
In effetti, il risultato è approssimativamente 1. Per simmetria nuovamente, comprendiamo che la derivata di e rispetto a d è anch’essa 1. Analiticamente:
\frac{\partial e(c, d)}{\partial d}=\lim _{h \rightarrow 0}{\frac{e(c, d+h)-e(c, d)}{h}} = {\frac{(c + d + h) - (c + d)}{h}} = {\frac{(c+d) + h - (c+d)}{h}} = {\frac{h}{h}} = 1
E ora che abbiamo entrambe le derivate parziali, possiamo moltiplicarle seguendo la regola della catena: 1 \times -3 = -3. Dunque, la derivata di L rispetto a c e d è -3. In termini matematici, abbiamo fatto qualcosa di equivalente a:
\frac{dz}{dx} = \frac{dz}{dy} \cdot \frac{dy}{dx}
Dove z dipende da y e, a sua volta, y dipende da x.
Infine, dobbiamo fare lo stesso per ottenere le derivate rispetto ad a e b. Allora, dato il pattern che avevamo scoperto, la derivata di c rispetto ad a è b, ossia 3, e viceversa: la derivata rispetto a b è a, ossia -2. Ma ricordiamo: queste derivate «locali» sono della funzione c, e a noi interessa la derivata di L, cioè la magnitudine dell’influenza che a e b hanno su L. Per saperlo, dobbiamo nuovamente applicare la regola della catena e moltiplicare le derivate che abbiamo per la derivata di L rispetto a c. Allora, la derivata parziale di L rispetto ad a è 3 \times -3 = -9, mentre la derivata parziale rispetto a b è -2 \times -3 = 612.
Ora che abbiamo questi valori, possiamo ottimizzare il nostro codice per contemplarli. Nella pratica, nessuno calcola le derivate manualmente come abbiamo fatto, poiché sarebbe un lavoro eterno; ma abbiamo già appreso i pattern per calcolarle, quindi possiamo implementarli nel nostro codice affinché si calcolino automaticamente:
import math

class Numero:
  def __init__(self, valor, _previos=(), _op='', etiqueta=''):
    self.valor = valor
    self.grad = 0.0
    self._propagar = lambda: None
    self._previos = set(_previos)
    self._op = _op
    self.etiqueta = etiqueta

  def __add__(self, otro):
    otro = otro if isinstance(otro, Numero) else Numero(otro)
    resultado = Numero(self.valor + otro.valor, (self, otro), '+')

    def _propagar():
      self.grad += 1.0 * resultado.grad
      otro.grad += 1.0 * resultado.grad
    resultado._propagar = _propagar

    return resultado

  def __mul__(self, otro):
    otro = otro if isinstance(otro, Numero) else Numero(otro)
    resultado = Numero(self.valor * otro.valor, (self, otro), '*')

    def _propagar():
      self.grad += otro.valor * resultado.grad
      otro.grad += self.valor * resultado.grad
    resultado._propagar = _propagar

    return resultado

  def __pow__(self, otro):
    assert isinstance(otro, (int, float))
    resultado = Numero(self.valor**otro, (self,), f'**{otro}')

    def _propagar():
      self.grad += otro * (self.valor ** (otro - 1)) * resultado.grad
    resultado._propagar = _propagar

    return resultado

  def tanh(self):
    t = (math.exp(2*self.valor) - 1) / (math.exp(2*self.valor) + 1)
    resultado = Numero(t, (self,), 'tanh')

    def _propagar():
      self.grad += (1 - t**2) * resultado.grad
    resultado._propagar = _propagar

    return resultado

  def propagar(self):
    topo = []
    visitados = set()
    def construir_topo(v):
      if v not in visitados:
        visitados.add(v)
        for previo in v._previos:
          construir_topo(previo)
        topo.append(v)
    construir_topo(self)

    self.grad = 1
    for nodo in reversed(topo):
      nodo._propagar()

  def __neg__(self):
    return self * -1

  def __sub__(self, otro):
    return self + (-otro)

  def __truediv__(self, otro):
    return self * otro**-1

  def __repr__(self):
    return f'Valor={self.valor}'
Ora che abbiamo la classe Numero aggiornata con la capacità di calcolare gradienti automaticamente, possiamo ricostruire il nostro grafo e propagare i gradienti:
a = Numero(-2.0, etiqueta='a')
b = Numero(3.0, etiqueta='b')
c = a*b; c.etiqueta = 'c'
d = Numero(10.0, etiqueta='d')
e = c + d; e.etiqueta = 'e'
f = Numero(-3.0); f.etiqueta = 'f'
L = f * e; L.etiqueta= 'L'

L.propagar()
Possiamo visualizzare il grafo con i gradienti calcolati:
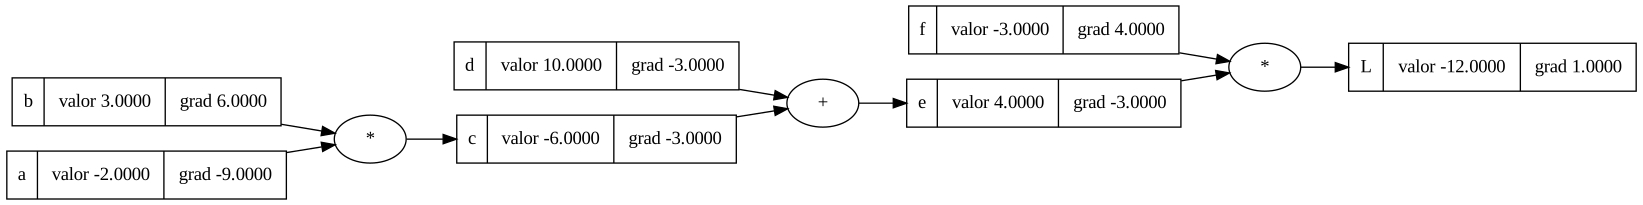
Ora, usiamo i gradienti per ottimizzare i nostri valori. Dato che la nostra funzione di perdita è positiva, vogliamo diminuirla. Se i gradienti ci indicano la direzione in cui possiamo aumentare il risultato di una funzione, allora in questo caso vogliamo andare in direzione opposta al gradiente, poiché ciò avrebbe come risultato una diminuzione del risultato della funzione. Per questo, sommeremo valore alle variabili nel senso inverso al gradiente.
Proviamo prima con una sola variabile:
a.valor += -0.1 * a.grad

a = Numero(a.valor, etiqueta='a')
b = Numero(3.0, etiqueta='b')
c = a*b; c.etiqueta = 'c'
d = Numero(10.0, etiqueta='d')
e = c + d; e.etiqueta = 'e'
f = Numero(-3.0); f.etiqueta = 'f'
L = f * e; L.etiqueta= 'L'

L.propagar()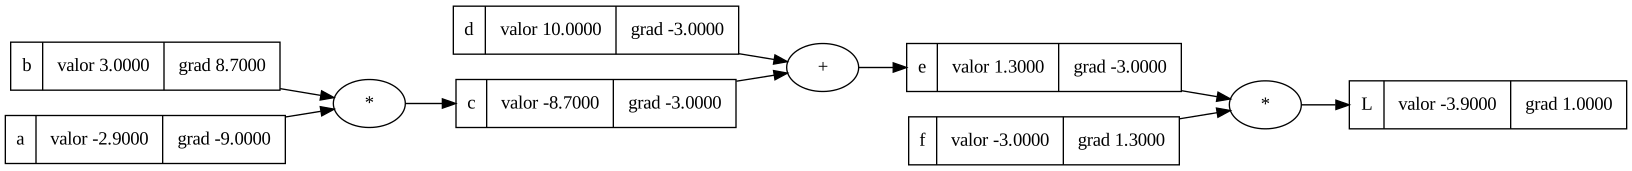
Bene, il risultato è passato da -12 a circa -9.3. Ora facciamolo con tutte le variabili:
for v in [a, b, d, f]:
  v.valor += -0.01 * v.grad

a = Numero(a.valor, etiqueta='a')
b = Numero(b.valor, etiqueta='b')
c = a*b; c.etiqueta = 'c'
d = Numero(d.valor, etiqueta='d')
e = c + d; e.etiqueta = 'e'
f = Numero(f.valor); f.etiqueta = 'f'
L = f * e; L.etiqueta= 'L'

L.propagar()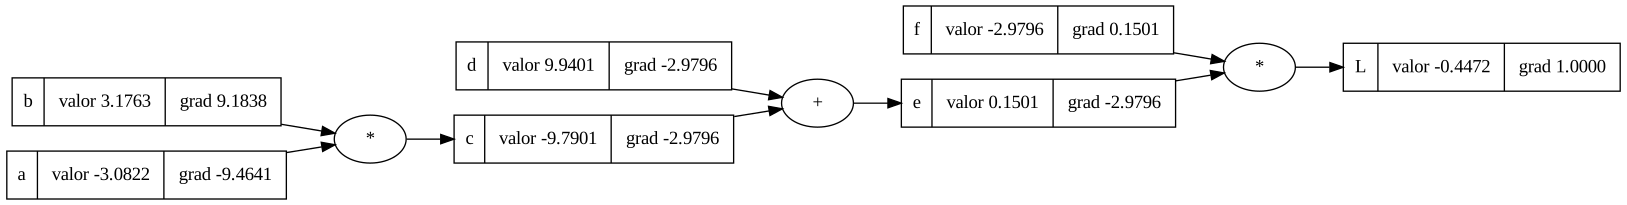
Il risultato ora si avvicina di più a 0, che era il nostro obiettivo.
In precedenza, abbiamo costruito una specie di neurone; tuttavia, il potere di una rete neurale consiste nel fatto che ha milioni di neuroni, tutti che ottimizzano i propri valori per darci il risultato che desideriamo (nel nostro esempio: 0).
Di seguito, costruiremo una rete neurale chiamata «percettrone multistrato» (Multilayer Perceptron o MLP in inglese) che ci permetterà di risolvere problemi pratici. Come esempio, la addestreremo affinché identifichi il sarcasmo nelle recensioni di film.
Per rilevare il sarcasmo nelle recensioni che gli utenti danno su un film, potremmo prendere come base due variabili: il sentimento (con valori da 1 a 5, dove 5 è un sentimento positivo e 1 uno negativo) e la valutazione assegnata (anch’essa con valori da 1 a 5). Il risultato dovrebbe essere 1 per sarcasmo e 0 per assenza di sarcasmo. Per esempio14:
Geniale, mi piace quando vedo un film dell’orrore con la solita trama di sempre. Valutazione: 2/5.
In questo caso, il sentimento è positivo (usa espressioni come «geniale», «mi piace»), ma la recensione è negativa, cosicché possiamo stabilire una relazione di proporzionalità inversa tra entrambe le variabili per rilevare il sarcasmo: se la valutazione è bassa ma il sentimento «alto», allora c’è sarcasmo (cioè, sarcasmo =1).
import random

class Neurona:
  def __init__(self, nentradas):
    self.peso = [Numero(random.uniform(-1,1)) for i in range(nentradas)]
    self.sesgo = Numero(random.uniform(-1,1))

  def __call__(self, x):
    activacion = sum((peso_i*x_i for peso_i, x_i in zip(self.peso, x)), self.sesgo)
    resultado = activacion.tanh()
    return resultado

  def parametros(self):
    return self.peso + [self.sesgo]
Ora possiamo creare un neurone e visualizzare la sua struttura:
sentimiento = Numero(5.0, etiqueta='sentimiento')
calificacion = Numero(5.0, etiqueta='calificacion')

N = Neurona(2)
neuron = N([sentimiento, calificacion])
neuron.propagar()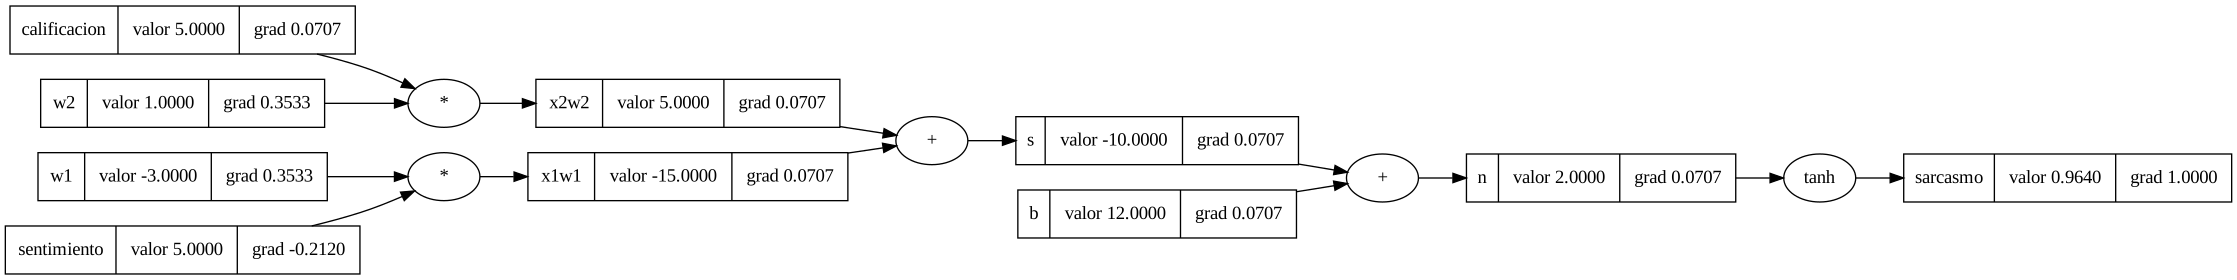
Per il momento, i nostri valori sono casuali e tutto funziona male. Per ottimizzare adeguatamente, sarà meglio creare un’architettura più robusta con molteplici strati.
Costruiremo uno «strato», che non è altro che un modo programmatico di definire quanti neuroni vogliamo per i nostri ingressi, e infine collegheremo il tutto con un «percettrone multistrato», che consiste nell’unire vari strati tra loro:
class Capa:
  def __init__(self, nentradas, nsalidas):
    self.neuronas = [Neurona(nentradas) for _ in range(nsalidas)]

  def __call__(self, x):
    resultado = [n(x) for n in self.neuronas]
    return resultado[0] if len(resultado) == 1 else resultado

  def parametros(self):
    return [parametro for n in self.neuronas for parametro in n.parametros()]

class MLP:
  def __init__(self, nentrada, nsalidas):
    tamaño = [nentrada] + nsalidas
    self.capas = [Capa(tamaño[i], tamaño[i+1]) for i in range(len(nsalidas))]

  def __call__(self, x):
    for capa in self.capas:
      x = capa(x)
    return x

  def parametros(self):
    return [parametro for capa in self.capas for parametro in capa.parametros()]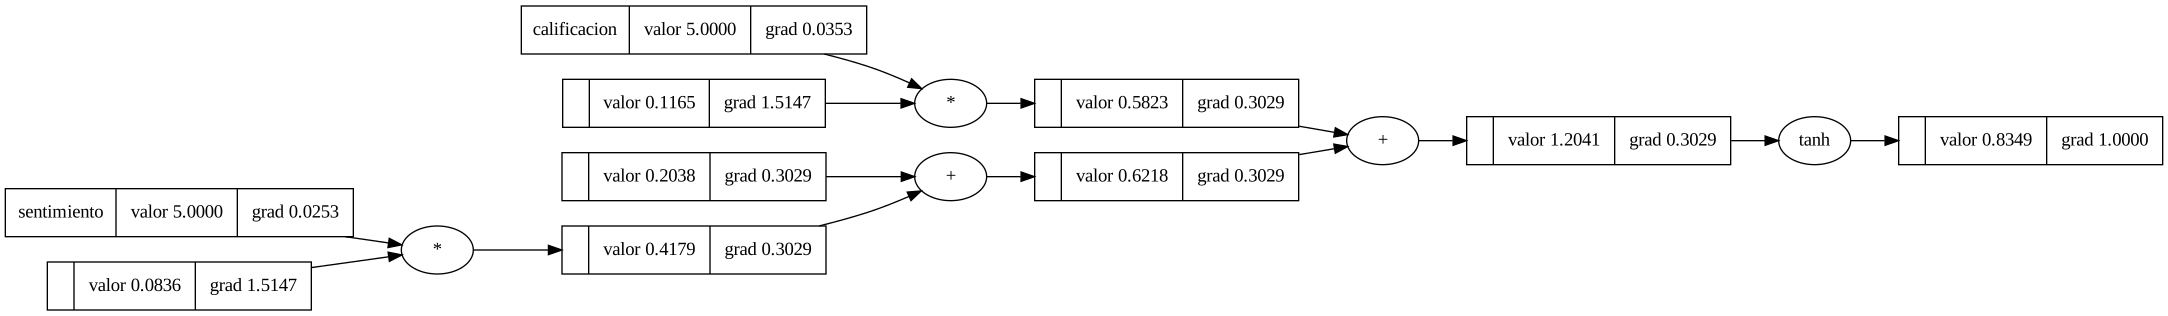
Daremo al nostro modello quattro input di addestramento (cioè saranno esempi affinché la rete neurale apprenda): ogni input avrà il sentimento e la valutazione assegnata, così come il valore obiettivo di sarcasmo che desideriamo:
RN = MLP(2, [4, 4, 1])

entradas = [
    [5.0, 5.0], # no sarcasmo
    [5.0, 1.0], # sarcasmo
    [5.0, 2.0], # sarcasmo
    [4.0, 5.0], # no sarcasmo
]

objetivos = [0.0, 1.0, 1.0, 0.0]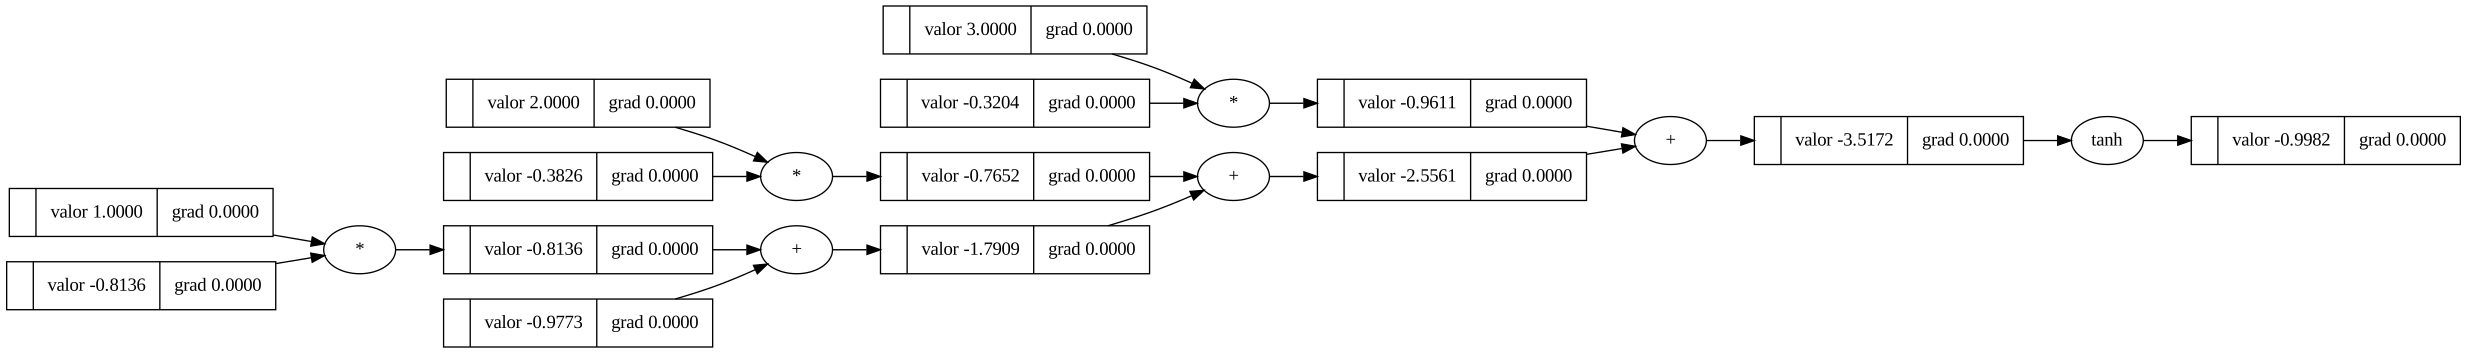
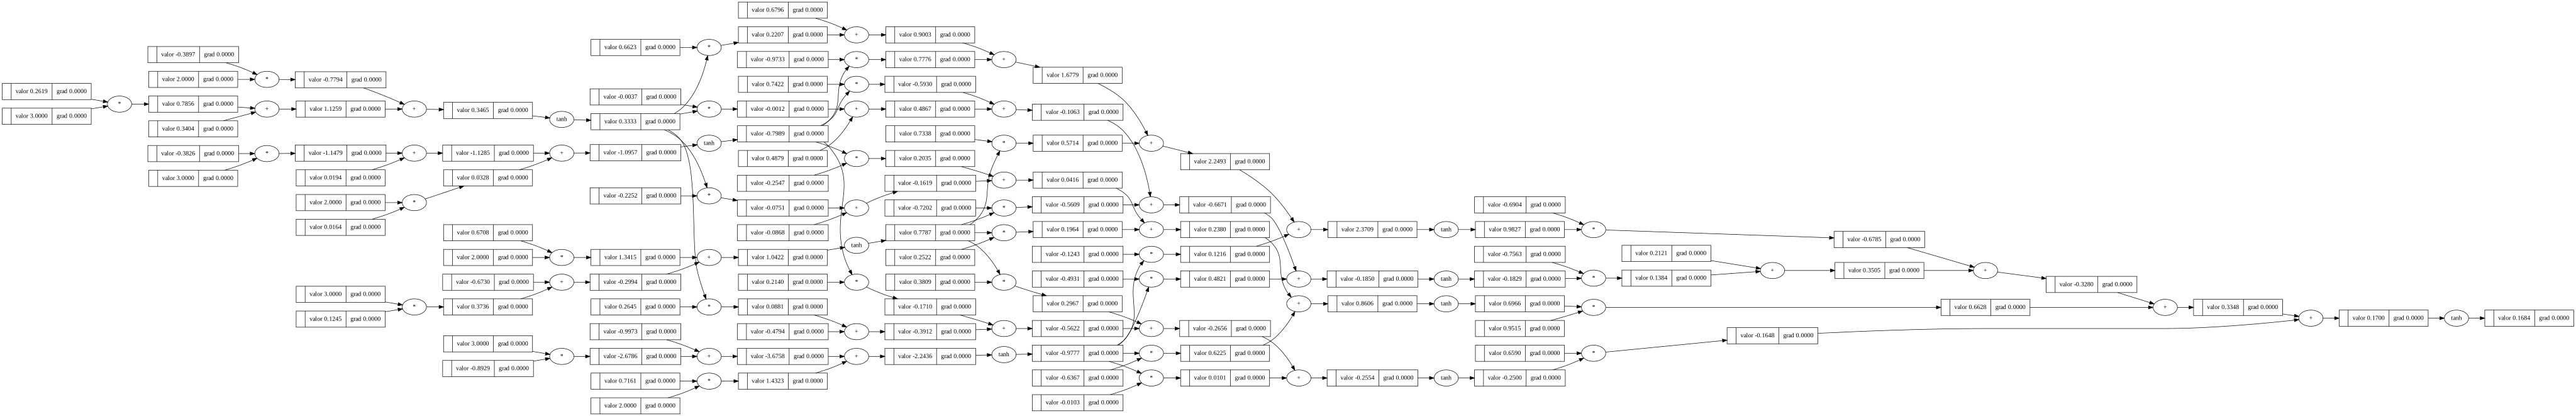
Le nostre predizioni di sarcasmo sono state generate con valori casuali, cosicché sono tutte errate. Ora, dobbiamo quantificare quanto sono lontane dal loro obiettivo. Per questo, creeremo una funzione che misuri la differenza tra l’obiettivo e la predizione15. Si tratta di una semplice sottrazione, ma la eleveremo al quadrato per ottenere solo numeri positivi:
for k in range(30):
  # paso hacia delante
  preds = [RN(x) for x in entradas]
  perdida = sum([(pred - obj)**2 for pred, obj in zip(preds, objetivos)])

  # propagación hacia atrás
  for p in RN.parametros():
    p.grad = 0.0
  perdida.propagar()

  # actualizar
  for p in RN.parametros():
    p.valor += -0.07 * p.grad

  print(k, perdida.valor)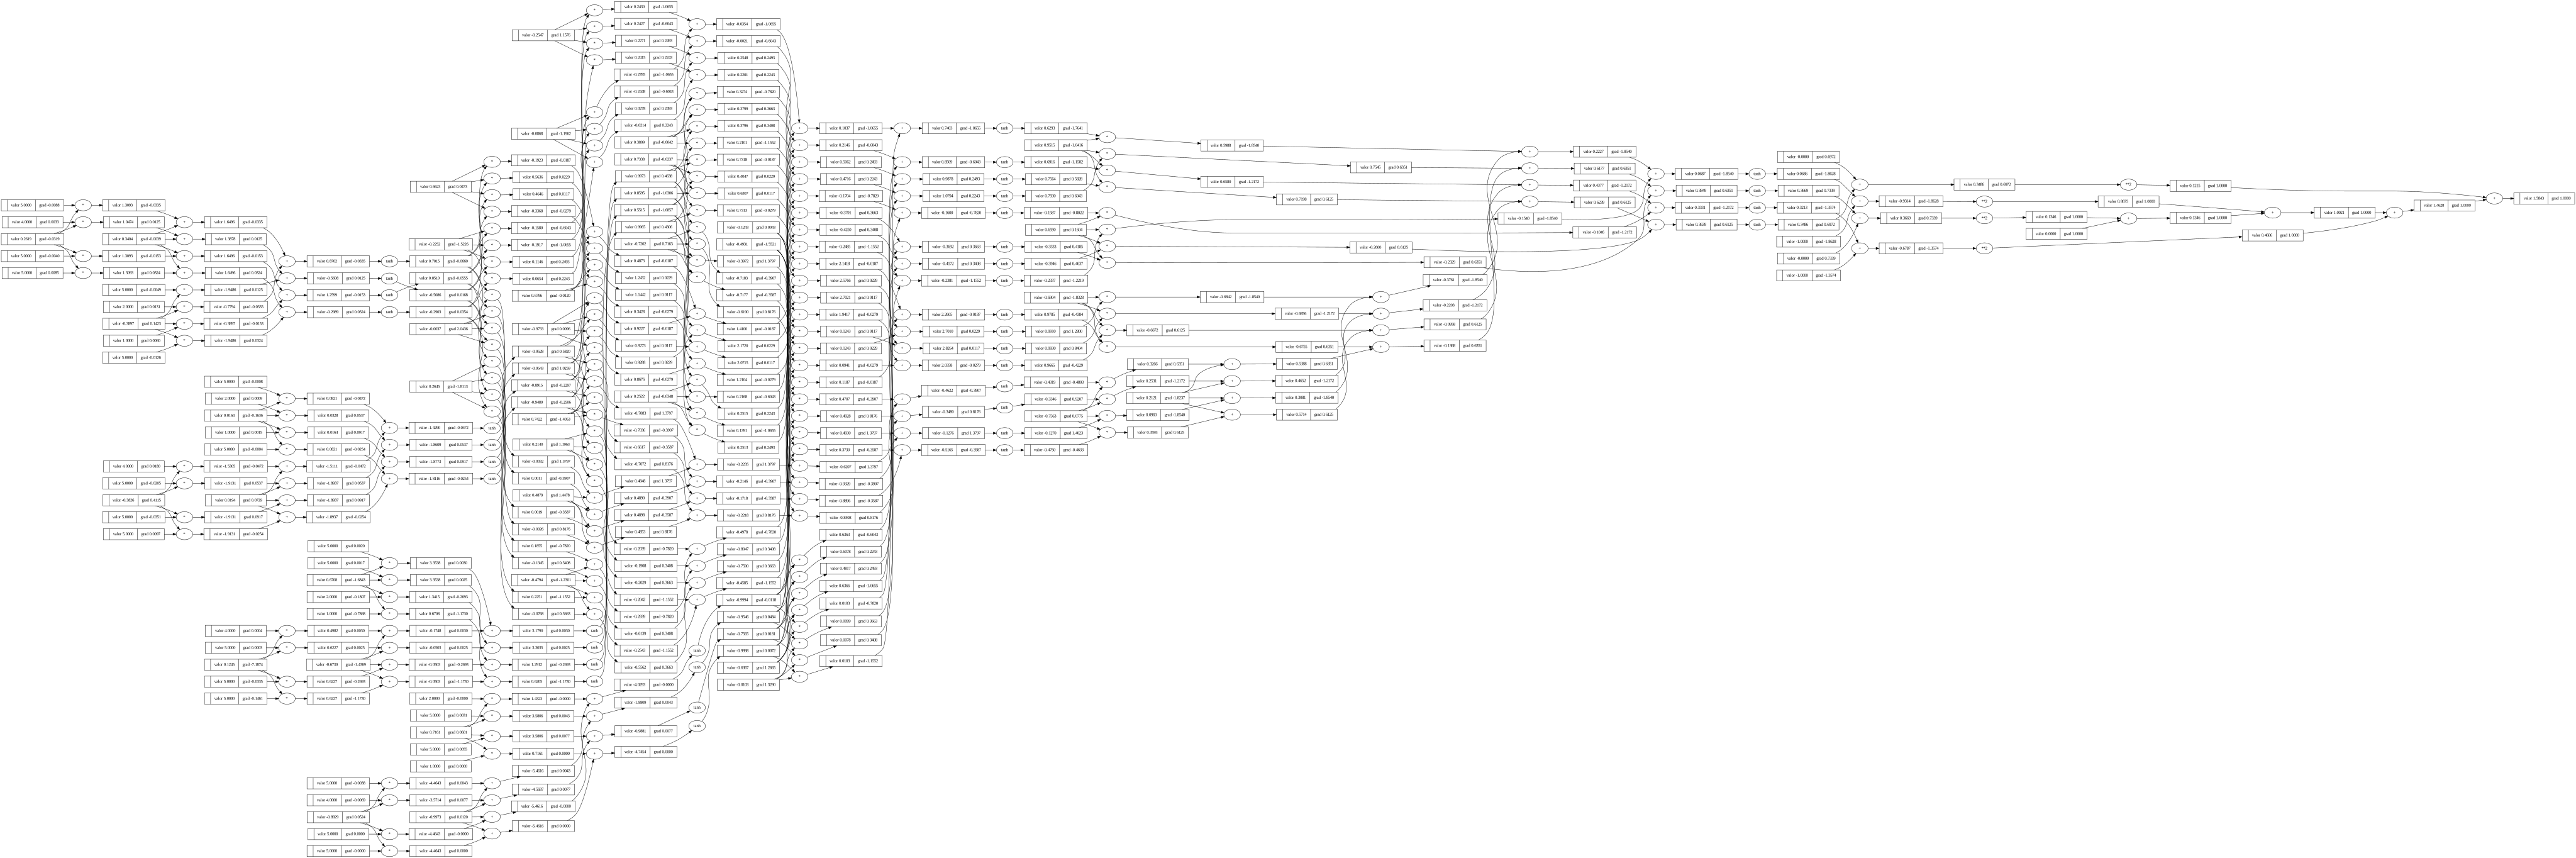
Nell’addestramento, la nostra funzione di perdita è diminuita quasi a zero16. Verifichiamo che le nostre predizioni siano ora più simili ai nostri obiettivi:
preds~ [≈0.10, ≈0.92, ≈0.90, ≈0.03]objetivos~ [0.0, 1.0, 1.0, 0.0]In effetti, il nostro modello è ora molto più capace di prima nel rilevare il sarcasmo. E se facessimo un test con una nuova valutazione? Il sentimento sarà 5 e la valutazione 1.5:
test = [5.0, 1.5]
prediccion = RN(test)
~ Valor=0.90La nostra rete neurale considera che esiste una probabilità del \approx90 \% che sia sarcasmo. Niente male.
I simboli \Delta, \delta sono lettere dell’alfabeto greco chiamate «delta», e generalmente si utilizzano in matematica per rappresentare o leggere un cambiamento: «cambiamento in y su cambiamento in x».↩︎
La parola «secante» significa «tagliare» in latino (secare), cosicché la linea secante è quella che taglia una figura quando la tocca in due punti. D’altra parte, la parola «tangente» significa «toccare» in latino (tangere), cosicché la tangente è una linea che tocca appena in un punto un’altra figura. La parola «tangibile» viene dalla stessa radice e da lì anche il suo significato.↩︎
Teniamo a mente quanto segue: la nostra funzione è curva perché la sua inclinazione cambia sempre, e la sua inclinazione cambia sempre perché ogni valore di x influisce su y in modo diverso. Intuitivamente, quando x=4, y risulta da 4^2, cioè y risulta dal moltiplicare 4 \times 4; ma quando x=5, y aumenta in una proporzione diversa: 5 \times 5. Al contrario, le rette o funzioni lineari cambiano sempre nella stessa proporzione (precedentemente, si moltiplicava sempre ogni x per 5), cosicché la loro inclinazione è unica e costante.↩︎
Per quanto ne so, fu Leibniz a inventare la derivata ragionando in un modo quasi identico al nostro.↩︎
Sui limiti si può leggere questo articolo; sulle derivate, sono raccomandabili anche questi video.↩︎
Ben vista, l’espressione \frac{dy}{dx} illustra alla perfezione il concetto: stiamo misurando la differenza nel valore di y (dy) che provoca un cambiamento infinitamente piccolo nella variabile x, cioè una piccola differenza (denotata da h) in x: dx. Infine, per conoscere la proporzione che mantengono tra loro, li dividiamo l’uno per l’altro, misurando la derivata (differenza) di y rispetto a x (cioè rispetto a una piccola differenza nel valore di x). Il nome «calcolo differenziale» viene precisamente dalla misurazione di quelle piccole differenze nei valori delle variabili.↩︎
Nella pratica, è anche comune vedere la derivata scritta semplicemente come la notazione di funzione prima: f'(x). Questa notazione indica anche «il tasso di cambiamento della funzione nel punto x».↩︎
A rigore, la derivata non si differenzia dalla pendenza solo per riferirsi a funzioni non lineari, ma anche perché è utile per misurare l’impatto che diverse variabili hanno in una funzione composta (cioè in una funzione di più di due dimensioni o variabili). Questo lo vedremo più avanti; tuttavia, è importante essere consapevoli del fatto che la nostra formulazione geometrica della derivata è un modo intuitivo (e legittimo in termini storici) di comprenderla, ma il suo concetto può essere esteso a problemi, funzioni e dimensioni più complesse che sono difficili da visualizzare.↩︎
Attenzione: diminuire il 3 aumenta il risultato, poiché viene moltiplicato per un numero negativo. Esempio: 3-1 = 2, 2 \times -2 = -4, e -4 è maggiore di -6, il risultato iniziale.↩︎
Il nome tecnico di questa derivata è «derivata parziale», poiché la funzione L è composta da molteplici variabili che, a loro volta, sono concatenate tra loro mediante altre funzioni (somma e moltiplicazione). In tal senso, L è una funzione composta, e desideriamo conoscere la derivata (parziale) di detta funzione rispetto a ciascuna variabile che la compone o, in altre parole, vogliamo determinare in che modo ogni variabile sta influenzando il risultato della funzione. In sintesi, se abbiamo una sola variabile nella funzione, allora parliamo di derivata; ma se abbiamo più di una variabile e stimiamo la derivata rispetto a ciascuna variabile individuale, allora parliamo di derivata parziale. La derivata parziale utilizza la notazione \frac{\partial y(x, z)}{\partial x} con una lettera «d» corsiva (\partial) per distinguersi. Dobbiamo fare attenzione a non confonderla con delta, la «d» greca (\delta).↩︎
Per approfondire la storia delle reti neurali e dell’apprendimento profondo in generale, e della propagazione all’indietro in particolare, si veda il lavoro di Schmidhuber e quello di Yuxi Liu.↩︎
Alla derivata globale, cioè a quella che si dà rispetto al risultato finale e non a quello locale, si denomina «gradiente». Le formule che utilizziamo per derivare possono essere lette qui.↩︎
Questa idea è stata attribuita a Benoît Mandelbrot, che la formulò nel contesto della geometria frattale.↩︎
L’esempio è ispirato a quello formulato da Sriraman Madhavan.↩︎
Questa funzione si chiama «errore quadratico medio» (o mean squared error, MSE in inglese); matematicamente possiamo definirla come \frac{1}{n} \sum_{i=1}^n (y_i - \hat{y}_i)^2. Questa espressione matematica è la «funzione di perdita» (loss function) più semplice che esista, poiché stiamo solo facendo una sommatoria con la differenza tra obiettivi e predizioni.↩︎
Al processo di «propagare all’indietro» le derivate parziali di ogni neurone si denomina «discesa del gradiente stocastica» (stochastic gradient descent) perché, come dicevamo, diminuiamo la funzione di perdita sulla base del gradiente. «Stocastico» significa «casuale» e utilizziamo questo termine perché all’inizio i nostri parametri w, b erano casuali.↩︎