Blog — Principios matemáticosDante Noguez |
Versión | 0.5.0 | |
|---|---|---|---|
| Lengua | EN/IT | ||
Este texto está inspirado en micrograd de Andrej Karpathy. A continuación, construiremos una red neuronal desde cero, explicando a detalle cada uno de sus elementos.
Las redes neuronales son gigantescas funciones matemáticas. La característica distintiva de estas funciones, que catalizan gran parte de lo que hoy se denomina «inteligencia artificial» (aunque, más estrictamente, deberíamos hablar de «aprendizaje profundo» o deep learning), es que pueden «aprender» a refinar, optimizar y generalizar las «reglas» (parámetros) que las componen. Tal proceso de aprendizaje consiste en la iteración de operaciones matemáticas propias del cálculo diferencial y vectorial. Por ello, para poder formular una red neuronal, procuraremos primero entender intuitivamente a la derivada: esa médula matemática del aprendizaje.
Para tal propósito, construiremos la derivada desde cero, utilizando apenas unas cuantas nociones básicas de geometría.
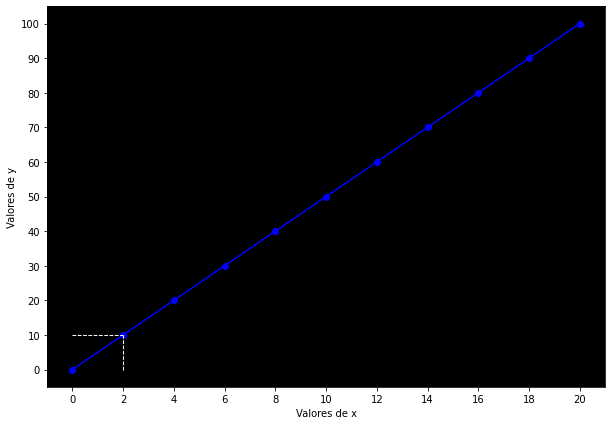
En geometría, denominamos «pendiente» al valor de la inclinación de una recta. Conceptualmente, la pendiente puede ser interpretada como la proporción del cambio que hay entre las variables x y y de la recta. En otras palabras, la pendiente mide qué tanto influye x en el valor de y, o qué tanto cambia y cuando avanzamos en x. Supongamos, por ejemplo, la recta de una función que podemos definir como f(x, b) = x \cdot b, donde:
x = np.arange(0, 21, 2)
b = 5
def f(x, b): return x*b
y = f(x, b)En términos más simples, la función es una multiplicación entre x (números del 0 al 20 en intervalos de 2) y b (es decir, 5).
Ahora, ¿cómo puedo saber cuánto está influyendo cada valor de x en cada valor de y? Es decir, si paso de x=2 a x=4, ¿qué le pasa a y? y avanza desde 10 hasta 20, es decir, cinco veces x: 5 \times 2 = 10. Y si paso de x=4 a x=6, es decir, si avanzo dos «pasos» en x, y nuevamente avanza cinco veces lo que avancé en x, pasando de 20 a 30.
En ese sentido, la proporción que hay entre x y y es de 5, 5 es el número que determina cada valor de y a partir de x o, dicho de otra forma, 5 es la «fuerza» con la que x influye en y. Esta intuición es clave, pero al mismo tiempo resulta evidente porque la definición de mi función —o sea, cada valor de y— indica que debo multiplicar x por 5. Al calcular la pendiente, es como si no supiéramos este número y tuviéramos que deducirlo matemáticamente.
La fórmula de la pendiente nos ofrece un método general para calcular esta proporción o fuerza de la que hablamos1:
Pendiente = \frac{y_2 - y_1}{x_2 - x_1} = \frac{\Delta y}{\Delta x}
Entonces la fórmula solo nos dice que debemos tomar dos puntos cualesquiera de x y y para calcular la pendiente. Por ejemplo, si consideramos los valores del punto denotado por las líneas punteadas en la gráfica anterior, de tal manera que x_1 = 2, y_1 = 10, podemos tomar el punto siguiente para calcular la pendiente o inclinación de la recta, de manera que:
Pendiente = \frac{20 - 10}{4 - 2} = \frac{10}{2} = 5
Pero las funciones lineales —es decir, las rectas—, por definición tienen la misma inclinación en todos sus puntos o segmentos. Comprobémoslo cambiando nuestras x_2, y_2:
Pendiente = \frac{y_2 - y_1}{x_2 - x_1} = \frac{60 - 10}{12 - 2} = \frac{50}{10} = 5
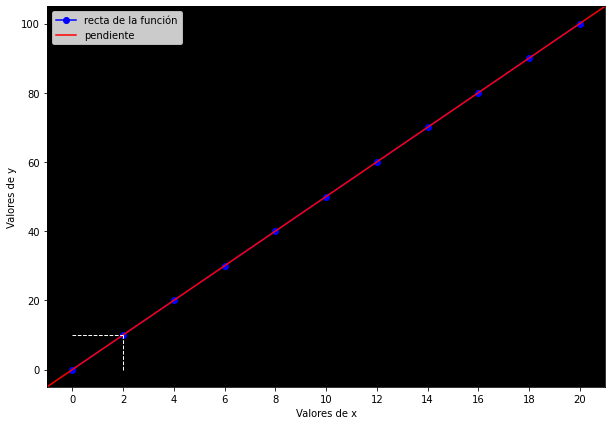
Naturalmente, la pendiente sigue siendo la misma. Ahora reiteremos, ¿exactamente qué quiere decir el número cinco? Que por cada paso que damos en x, y avanza cinco veces más. Dicho de otra forma, y es el resultado de multiplicar x por cinco; o x influye con una «fuerza» de cinco veces sí misma en y; o x transforma a y con una fuerza de cinco veces sí misma.
La pendiente es idéntica a la recta porque, como decíamos, la recta tiene la misma inclinación —pendiente— en todos sus puntos. Ahora, el problema con la pendiente es que esta propiedad es al mismo tiempo una limitación fundamental: la pendiente solo es válida para una recta o función lineal.
Dado que las funciones no lineales no tienen la misma inclinación en todos sus puntos, no podemos hablar de la «inclinación» ni de la «pendiente de una función no lineal». Visualicémoslo con una función cuadrática, donde mis valores de x ahora van del 0 al 5.99. Digamos también que me interesa saber la inclinación o «pendiente» de la función cuando x=5:
x = np.arange(0, 6, 0.0001)
def nolineal(x): return x**2
y = nolineal(x)

pendiente = (5**2 - 2**2) / (5 - 2)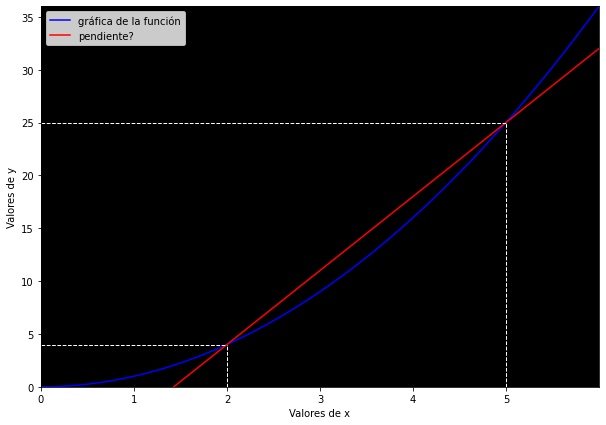
Para calcular la inclinación de la función (es decir, la curva azul) cuando x=5, he utilizado la fórmula de la pendiente tomando como referencia los puntos x_1=2, x_2=5, de tal manera que:
Pendiente = \frac{y_2 - y_1}{x_2 - x_1} = \frac{25 - 4}{5 - 2} = \frac{21}{3} = 7
Pero la realidad es que mi función no cambió en esa proporción con respecto al punto x=5: esa pendiente de 7 corresponde a la secante2 que atraviesa la función, no a la «pendiente» del punto x=5. La gráfica evidencia que el resultado es inexacto: queda claro que la función tiene una inclinación distinta a la de la recta roja3.
Además de que la función tiene múltiples «pendientes» —porque su inclinación siempre cambia—, estas «pendientes» son inexactas, puesto que no miden con precisión el impacto (o inclinación) de un solo punto en la función, sino que la fórmula de la pendiente necesariamente nos ofrece la inclinación de una recta trazada entre dos valores de x y dos valores de y. Puesto que la función con la que lidiamos ahora es curva, los puntos de x y y que tomamos no son satisfactorios porque denotan una línea, no una curva. En ese sentido, el resultado está sesgado.
Entonces, ¿cómo puedo hacer para encontrar el verdadero impacto de x en y? Podemos pensar en el siguiente truco: si la pendiente de la secante, aunque errónea, se acerca de alguna forma a nuestro valor deseado, ¿no podríamos hacer una secante más pequeña, tal que fuera más similar al punto que nos interesa? Es decir, si tomáramos la pendiente de la distancia entre dos puntos de x más cercanos entre sí, eso tendría que darnos una mejor aproximación al resultado correcto, ¿no?
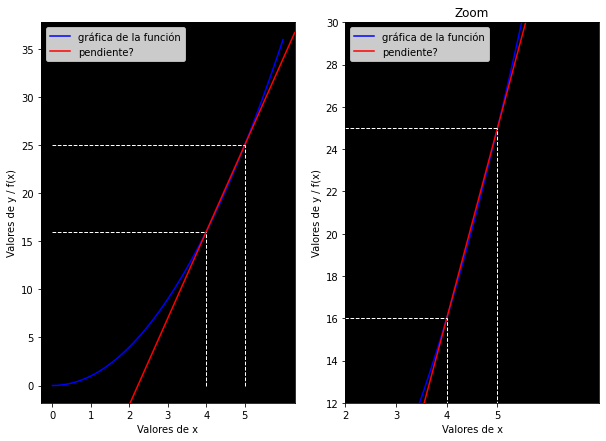
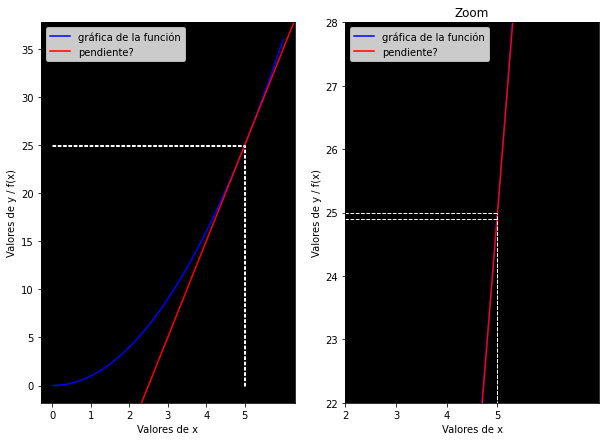
Gráficamente podemos comprobar que hemos obtenido un mucho mejor resultado: la secante que trazamos tiene una inclinación similar a la de la curva de la función. Pero las líneas punteadas —las cuales denotan los puntos que hemos tomado como referencia para calcular la pendiente— nos indican que todavía podemos mejorar, tomando como referencia coordenadas más cercanas entre sí.
Bien, pues antes de continuar experimentando, adelantemos ya que esta línea de razonamiento es precisamente la que dio origen a la derivada. El truco es este: podemos calcular la pendiente de líneas secantes cada vez más pequeñas y similares a nuestro punto, obteniendo cada vez mejores resultados. Es más, podemos llegar a calcular la pendiente de una línea infinitamente pequeña, tan pequeña que sería casi idéntica al punto, y la pendiente de esa línea infinitamente pequeña sería igual a la pendiente del punto. En ese mismo sentido, podríamos decir incluso —y de hecho se hace así en el ámbito matemático— que estamos calculando la pendiente de una línea tangente al punto, puesto que su pendiente sería igual a la de una secante infinitamente pequeña que se confunde con el punto4.
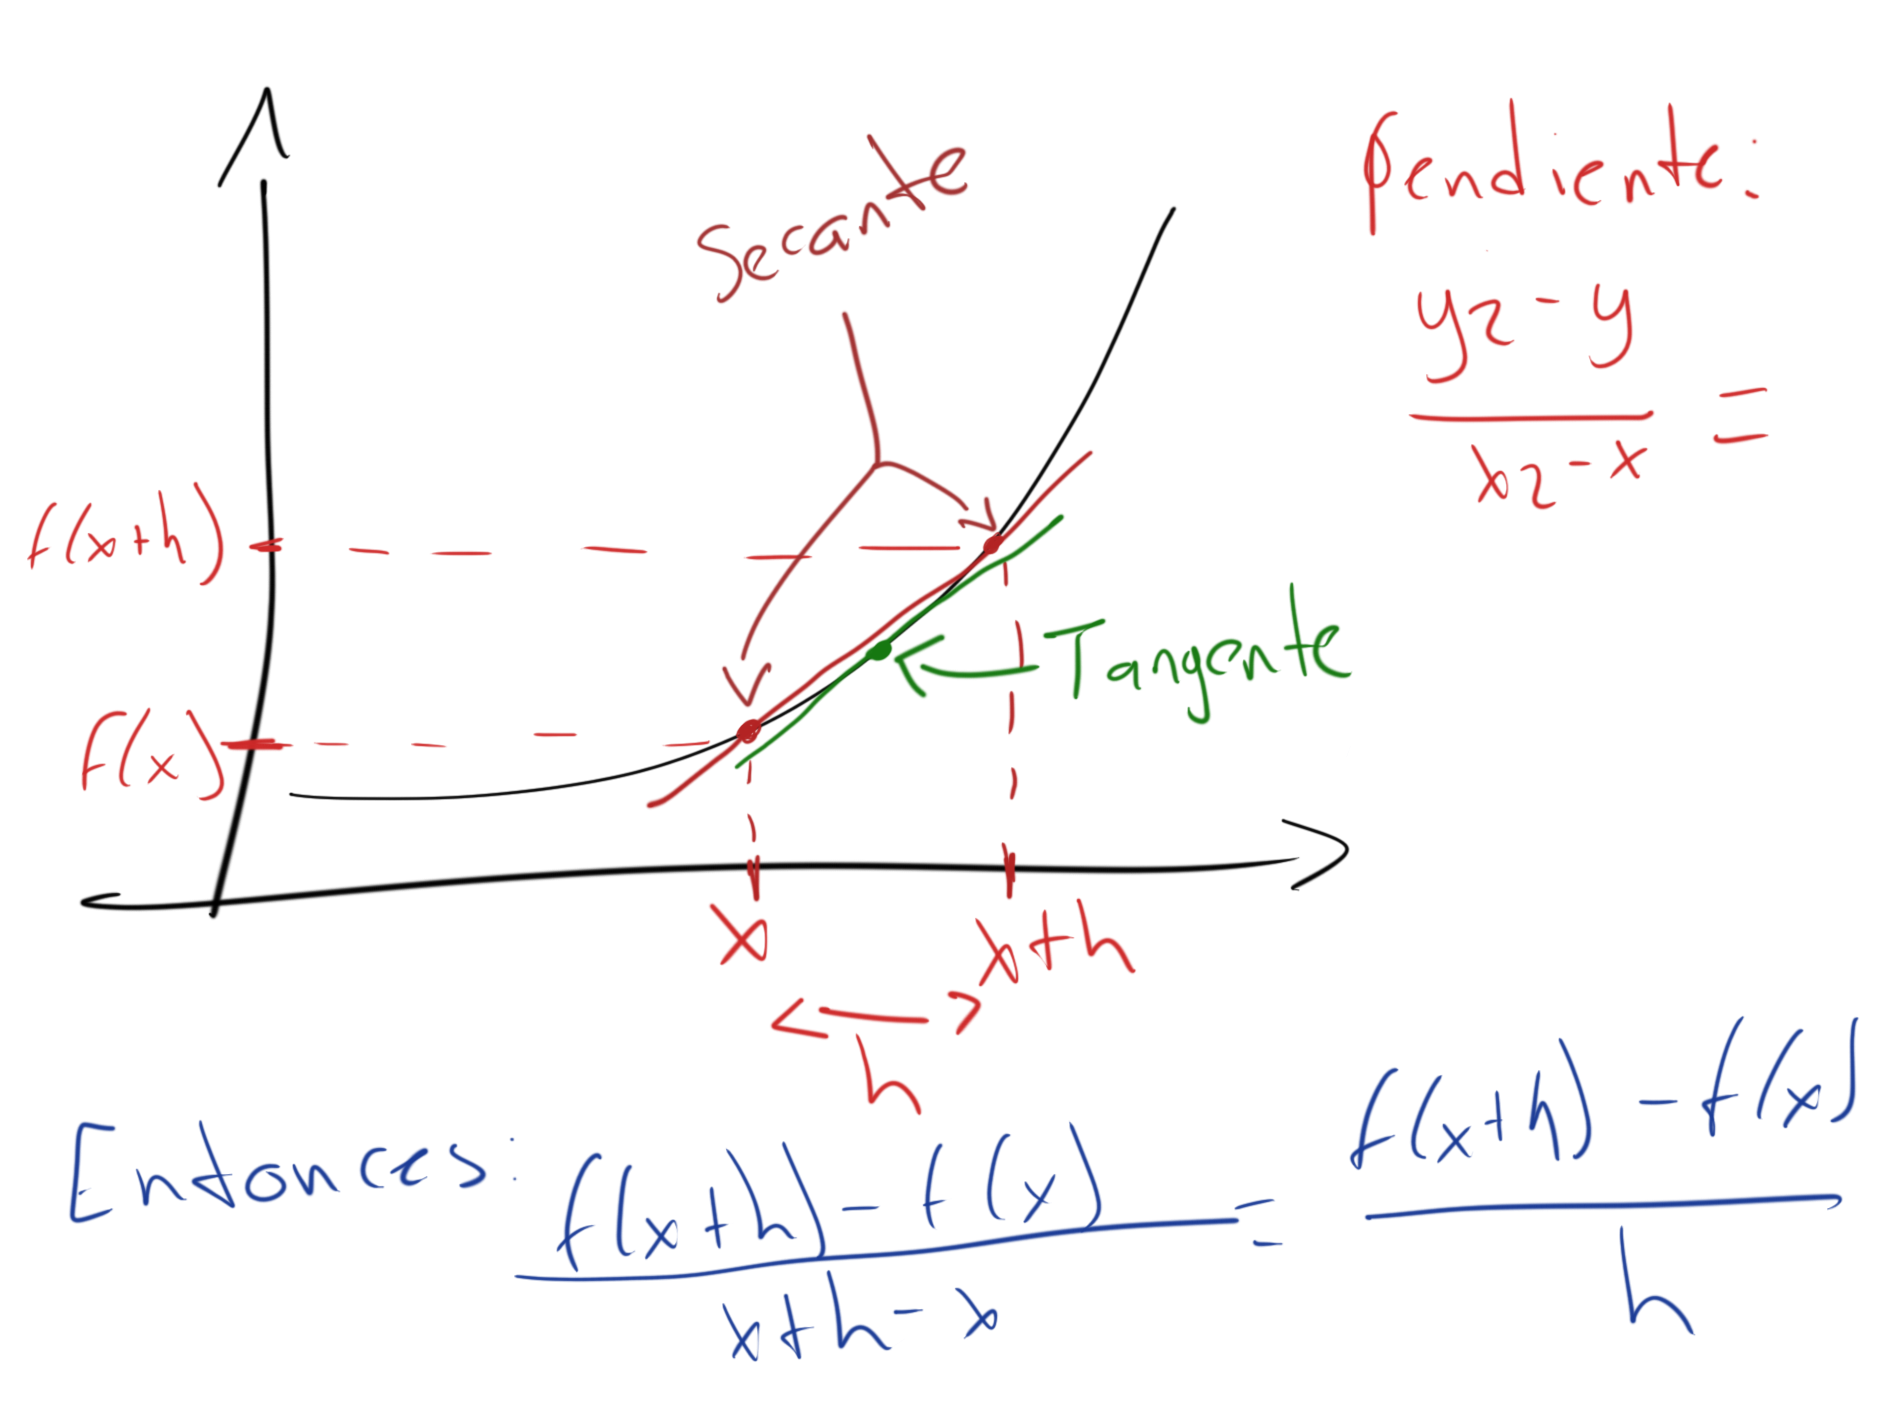
Utilizando la fórmula de la pendiente para poner en práctica nuestra intuición:
Pendiente = \frac{y_2 - y_1}{x_2 - x_1} = \frac{f(x+h) - f(x)}{(x+h) - x} = \frac{f(x+h) - f(x)}{h}
Como decía, idealmente queremos que la distancia h sea lo más pequeña posible, es decir, lo más cercana a 0 posible (sin ser 0, puesto que necesitamos una distancia entre dos x para tener una línea y así ser capaces de obtener su pendiente, puesto que un punto no tiene pendiente). Para expresar esta idea, emplearemos la expresión \lim _{h \rightarrow 0}, es decir, «cuando h es tan pequeña que se acerca a 0» o, más estrictamente, «el límite de la función cuando h tiende a 0». De tal manera que:
\lim _{h \rightarrow 0} \frac{f(x+h) - f(x)}{h}
Pero ahora ya no hablamos de una pendiente exactamente, sino que la estamos alterando para conseguir un resultado distinto5. A este nuevo concepto lo denominaremos «derivada»:
Derivada = \lim _{h \rightarrow 0} \frac{f(x+h) - f(x)}{h}
En la práctica también suele escribirse como \frac{dy}{dx}, o f'(x)6.
Aplicada a nuestro problema, podemos utilizarla así:
\frac{dy}{dx} =\lim _{h \rightarrow 0} \frac{f(x+h) - f(x)}{h} = \frac{(5+0.001)^2 - 5^2}{0.001} = 10.00
Programáticamente:
def derivada(f, x):
  h = 0.001
  return (f(x+h) - f(x)) / h

derivada(nolineal, 5)
~ 10.001000000002591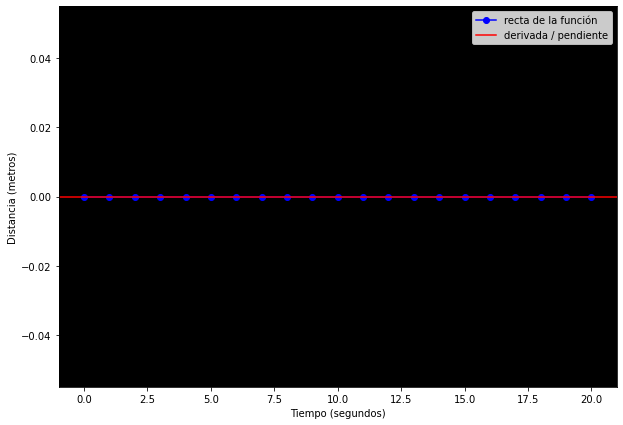
Finalmente hemos descubierto que cuando x=5, x «influye» en y con una «fuerza» de 107. Analíticamente, podemos comprobarlo de esta forma:
\begin{gather*} \frac{dy}{dx} =\lim _{h \rightarrow 0} \frac{(x+h)^2 - x^2}{h} = \lim _{h \rightarrow 0} \frac{(x+h)(x+h) - x^2}{h} = \lim _{h \rightarrow 0} \frac{x^2 + xh + hx + h^2 - x^2}{h} \\ = \lim _{h \rightarrow 0} \frac{2xh + h^2}{h} = \lim _{h \rightarrow 0} \frac{h(2x + h)}{h} = \lim _{h \rightarrow 0} (2x + h) = 2x + 0 = 2x \end{gather*}
Ahora, podemos generalizar esta expresión bajo la fórmula nx^{n-1}, es decir, cuando f(x) = x^2 y x=5, entonces:
\begin{gather*} 2x = 2(5) = 10 \\ nx^{n-1} = 2(5)^{2-1} = 10 \end{gather*}
En suma, 10 es efectivamente la proporción o fuerza con la que x influye en y, 10 es la derivada de y con respecto a x cuando x=5. Y, según hemos visto, podemos obtener este resultado de formas distintas: aplicando la fórmula, programáticamente, geométricamente y analítica o algebraicamente. En general, toda fórmula o expresión matemática tiene un trasfondo racional como los que hemos llevado a cabo, aunque las más de las veces se requieren algunos desarrollos lógico-matemáticos ulteriores para generalizarlas.
Volviendo a lo nuestro, podemos concluir que, conceptualmente, la derivada —igual que la pendiente— mide la proporción o magnitud del cambio que una variable provoca en el resultado de una función. Digamos que la derivada mide la fuerza con la que una variable influye —en un determinado punto— en el resultado de una función8.
Imaginemos que tenemos dos variables: x = -2 y y = 3. La función f(x, y) las multiplica y su resultado es -6. Sin embargo, queremos alterar ese resultado para que sea 0 y tenemos una restricción: la única manera de hacerlo es a través de las variables de entrada9.
Si recordamos la lección aprendida en las derivadas, se nos puede ocurrir utilizarlas para resolver este problema: dado que la derivada me dice el impacto que tiene una variable de entrada en la función, ¿será posible utilizarla para alterar el resultado de la función? Es decir, si la derivada me dice la magnitud del impacto que una variable tiene en el resultado, entonces debería poder utilizar esa información para influir en el resultado de manera más eficiente.
Para entender mejor la posible solución planteada, crearemos programáticamente la clase Numero, es decir, formularemos una estructura que nos permita definir, modificar y operar con números. De momento, cada Numero tendrá las siguientes propiedades: un valor, un par de valores previos para el caso de que el valor haya sido generado mediante una operación (por ejemplo, 2 y 2 en el caso de que multiplicados hayan generado el número 4), la operación que generó dicho valor (en nuestro ejemplo, la multiplicación) y una etiqueta en caso de que queramos asociar nuestro valor a una variable. Por ahora, únicamente tendremos las operaciones de suma, multiplicación, resta y división:
class Numero:
  def __init__(self, valor, _previos=(), _op='', etiqueta=''):
    self.valor = valor
    self._previos = set(_previos)
    self._op = _op
    self.etiqueta = etiqueta

  def __add__(self, otro):
    otro = otro if isinstance(otro, Numero) else Numero(otro)
    resultado = Numero(self.valor + otro.valor, (self, otro), '+')
    return resultado

  def __mul__(self, otro):
    otro = otro if isinstance(otro, Numero) else Numero(otro)
    resultado = Numero(self.valor * otro.valor, (self, otro), '*')
    return resultado

  def __sub__(self, otro):
    return self + (-otro)

  def __truediv__(self, otro):
    return self * otro**-1

  def __neg__(self):
    return self * -1

  def __repr__(self):
    return f'Valor={self.valor}'
Utilizaremos un problema más desafiante que una simple multiplicación:
a = Numero(-2.0, etiqueta='a')
b = Numero(3.0, etiqueta='b')
c = a*b; c.etiqueta = 'c'
d = Numero(10.0, etiqueta='d')
e = c + d; e.etiqueta = 'e'
f = Numero(-3.0); f.etiqueta = 'f'
L = f * e; L.etiqueta= 'L'
Podemos visualizar este grafo computacional:
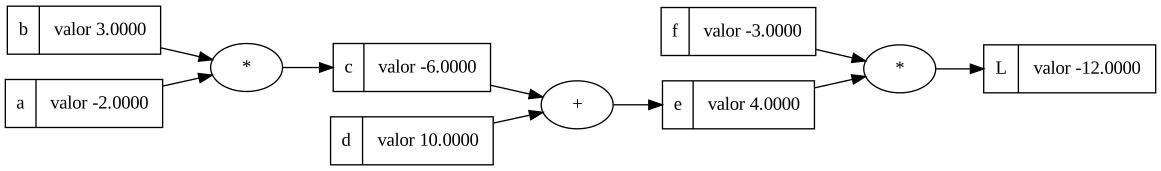
Como decíamos, intuitivamente creemos que la derivada puede ayudarnos: con la derivada sabemos qué impacto tiene cada variable en el resultado final L. En ese sentido, lo que tendremos que hacer primero es calcular la derivada de L con respecto a cada variable10.
En principio, la derivada de L con respecto a sí misma es 1: aunque suene absurdo y evidente a la vez, el cambio en L es proporcional (idéntico) a sí mismo. Ahora, la derivada de L con respecto a f y e la podemos averiguar con la fórmula que veníamos utilizando:
def derivada():
  h = 0.000001
  # Función original
  a = Numero(-2.0, etiqueta='a')
  b = Numero(3.0, etiqueta='b')
  c = a*b; c.etiqueta = 'c'
  d = Numero(10.0, etiqueta='d')
  e = c + d; e.etiqueta = 'e'
  f = Numero(-3.0); f.etiqueta = 'f'
  L1 = f * e

  # Función con incremento h
  a = Numero(-2.0, etiqueta='a')
  b = Numero(3.0, etiqueta='b')
  c = a*b; c.etiqueta = 'c'
  d = Numero(10.0, etiqueta='d')
  e = c + d; e.etiqueta = 'e'
  e.valor += h
  f = Numero(-3.0); f.etiqueta = 'f'
  L2 = f * e

  print((L2 - L1) / h)

derivada()
~ Valor=-3.0La derivada de la función L con respecto a e es aproximadamente -3. A estas alturas, ya habremos notado un patrón: cuando derivamos una multiplicación, la derivada parcial con respecto al multiplicando es el multiplicador. En este caso, L es el resultado de multiplicar e con f. Vimos que la derivada con respecto a e es -3, o sea f. Podemos inducir, empíricamente y por simetría, que la derivada con respecto a f es e, o sea 4.
Quizá también sea una buena oportunidad para demostrar analíticamente lo que venimos diciendo. Utilizando nuestra fórmula matemática, tenemos que:
\frac{\partial L(e, f)}{\partial e}=\lim _{h \rightarrow 0}{\frac{L(e + h, f)-L(e, f)}{h}} = {\frac{(e + h) \cdot f - e \cdot f}{h}} = {\frac{ef + hf - ef}{h}} = {\frac{hf}{h}} = f
Y aunque la notación aparente complejidad, en realidad solo estamos sumando, multiplicando, restando y dividiendo.
Ahora que ya tenemos esta información, queremos continuar al nodo anterior: las derivadas con respecto a c y d. Pero aquí hay una sutileza que, bien entendida, nos dará la clave de las redes neuronales: debemos obtener la derivada de L con respecto a c y d, no la derivada de e con respecto a ellas. Entonces, ¿cómo podemos averiguar el impacto que c y d tienen en L a través de e? Para hacer este cálculo solo hace falta una intuición bastante simple11.
Tomemos prestada la analogía de George Simmons: si una bicicleta es dos veces más rápida que una persona corriendo, y un automóvil cuatro veces más rápido que una bicicleta, entonces el automóvil es 2 \times 4 = 8 veces más rápido que una persona corriendo.
De igual forma, si queremos saber la influencia que c tiene en L, solo debemos obtener la derivada de e con respecto a c, y multiplicarla por la derivada de L con respecto a e. Es decir, debemos multiplicar la fuerza de c en e y la de e en L para saber con cuánta fuerza influye c en L. Lo mismo vale para d y todas las demás; a esta regla se le llama «regla de la cadena» (y mediante ella se realiza la «propagación hacia atrás» en el campo de la inteligencia artificial).
Ahora, para obtener la derivada de e con respecto a c, recordemos otro patrón que vimos: en una suma, la derivada nos daba como resultado 1 porque la función avanzaba en la misma proporción que avanzaba la variable. Verifiquémoslo:
def deriv_e(c, d):
  return (((c+0.00001)+d) - (c+d)) / 0.00001

deriv_e(-6, 10)
~ 1.0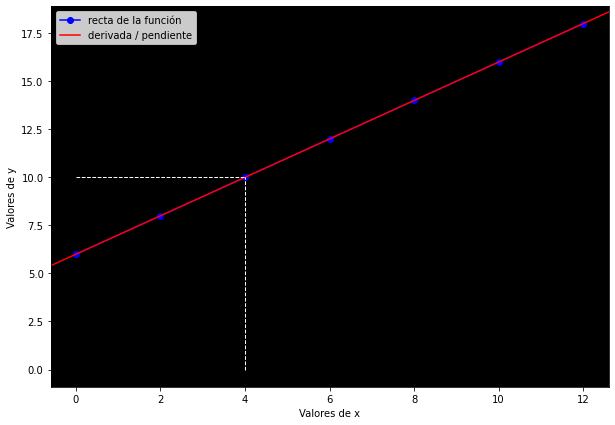
En efecto, el resultado es aproximadamente 1. Por simetría nuevamente, entendemos que la derivada de e con respecto a d también es 1. Analíticamente:
\frac{\partial e(c, d)}{\partial d}=\lim _{h \rightarrow 0}{\frac{e(c, d+h)-e(c, d)}{h}} = {\frac{(c + d + h) - (c + d)}{h}} = {\frac{(c+d) + h - (c+d)}{h}} = {\frac{h}{h}} = 1
Y ahora que ya tenemos ambas derivadas parciales, podemos multiplicarlas siguiendo la regla de la cadena: 1 \times -3 = -3. Así pues, la derivada de L con respecto a c y d es -3. En términos matemáticos, hemos hecho algo equivalente a:
\frac{dz}{dx} = \frac{dz}{dy} \cdot \frac{dy}{dx}
Donde z depende de y y, a su vez, y depende de x.
Finalmente, debemos hacer lo mismo para obtener las derivadas con respecto a a y b. Entonces, dado el patrón que habíamos descubierto, la derivada de c con respecto a a es b, o sea 3, y viceversa: la derivada con respecto a b es a, o sea -2. Pero recordemos: estas derivadas «locales» son de la función c, y a nosotros nos interesa la derivada de L, es decir, la magnitud de la influencia que a y b tienen en L. Para saberlo, nuevamente debemos aplicar la regla de la cadena y multiplicar las derivadas que tenemos por la derivada de L con respecto a c. Entonces, la derivada parcial de L con respecto a a es 3 \times -3 = -9, mientras que la derivada parcial con respecto a b es -2 \times -3 = 612.
Ahora que ya tenemos estos valores, podemos optimizar nuestro código para contemplarlos. En la práctica, nadie calcula las derivadas manualmente como lo hicimos, puesto que sería una labor eterna; pero ya hemos aprendido los patrones para calcularlas, así que podemos implementarlos en nuestro código para que se calculen automáticamente:
import math

class Numero:
  def __init__(self, valor, _previos=(), _op='', etiqueta=''):
    self.valor = valor
    self.grad = 0.0
    self._propagar = lambda: None
    self._previos = set(_previos)
    self._op = _op
    self.etiqueta = etiqueta

  def __add__(self, otro):
    otro = otro if isinstance(otro, Numero) else Numero(otro)
    resultado = Numero(self.valor + otro.valor, (self, otro), '+')

    def _propagar():
      self.grad += 1.0 * resultado.grad
      otro.grad += 1.0 * resultado.grad
    resultado._propagar = _propagar

    return resultado

  def __mul__(self, otro):
    otro = otro if isinstance(otro, Numero) else Numero(otro)
    resultado = Numero(self.valor * otro.valor, (self, otro), '*')

    def _propagar():
      self.grad += otro.valor * resultado.grad
      otro.grad += self.valor * resultado.grad
    resultado._propagar = _propagar

    return resultado

  def __pow__(self, otro):
    assert isinstance(otro, (int, float))
    resultado = Numero(self.valor**otro, (self,), f'**{otro}')

    def _propagar():
      self.grad += otro * (self.valor ** (otro - 1)) * resultado.grad
    resultado._propagar = _propagar

    return resultado

  def tanh(self):
    t = (math.exp(2*self.valor) - 1) / (math.exp(2*self.valor) + 1)
    resultado = Numero(t, (self,), 'tanh')

    def _propagar():
      self.grad += (1 - t**2) * resultado.grad
    resultado._propagar = _propagar

    return resultado

  def propagar(self):
    topo = []
    visitados = set()
    def construir_topo(v):
      if v not in visitados:
        visitados.add(v)
        for previo in v._previos:
          construir_topo(previo)
        topo.append(v)
    construir_topo(self)

    self.grad = 1
    for nodo in reversed(topo):
      nodo._propagar()

  def __neg__(self):
    return self * -1

  def __sub__(self, otro):
    return self + (-otro)

  def __truediv__(self, otro):
    return self * otro**-1

  def __repr__(self):
    return f'Valor={self.valor}'
Ahora que tenemos la clase Numero actualizada con la capacidad de calcular gradientes automáticamente, podemos reconstruir nuestro grafo y propagar los gradientes:
a = Numero(-2.0, etiqueta='a')
b = Numero(3.0, etiqueta='b')
c = a*b; c.etiqueta = 'c'
d = Numero(10.0, etiqueta='d')
e = c + d; e.etiqueta = 'e'
f = Numero(-3.0); f.etiqueta = 'f'
L = f * e; L.etiqueta= 'L'

L.propagar()
Podemos visualizar el grafo con los gradientes calculados:
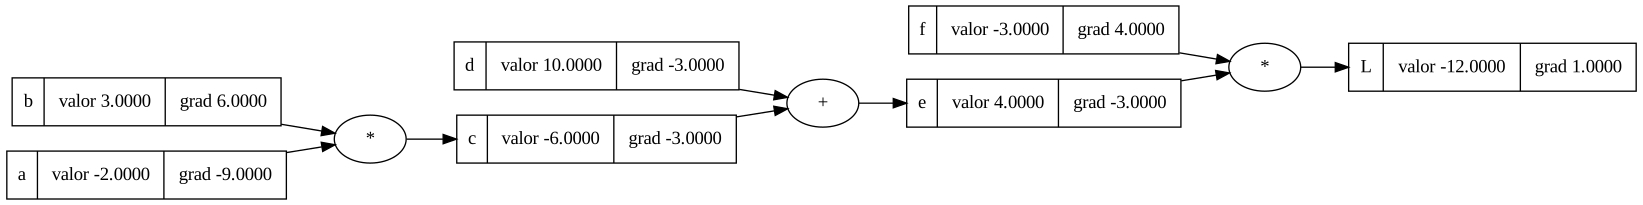
Ahora, usemos los gradientes para optimizar nuestros valores. Dado que nuestra función de pérdida es positiva, queremos disminuirla. Si los gradientes nos indican la dirección en la que podemos aumentar el resultado de una función, entonces en este caso queremos ir en dirección opuesta al gradiente, pues eso tendría como resultado una disminución del resultado de la función. Para ello, sumaremos valor a las variables en el sentido inverso al gradiente.
Probemos primero con solo una variable:
a.valor += -0.1 * a.grad

a = Numero(a.valor, etiqueta='a')
b = Numero(3.0, etiqueta='b')
c = a*b; c.etiqueta = 'c'
d = Numero(10.0, etiqueta='d')
e = c + d; e.etiqueta = 'e'
f = Numero(-3.0); f.etiqueta = 'f'
L = f * e; L.etiqueta= 'L'

L.propagar()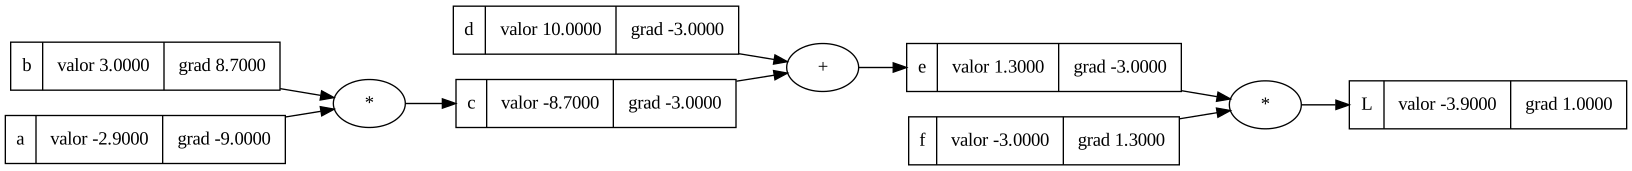
Bien, el resultado pasó de -12 a aproximadamente -9.3. Ahora hagámoslo con todas las variables:
for v in [a, b, d, f]:
  v.valor += -0.01 * v.grad

a = Numero(a.valor, etiqueta='a')
b = Numero(b.valor, etiqueta='b')
c = a*b; c.etiqueta = 'c'
d = Numero(d.valor, etiqueta='d')
e = c + d; e.etiqueta = 'e'
f = Numero(f.valor); f.etiqueta = 'f'
L = f * e; L.etiqueta= 'L'

L.propagar()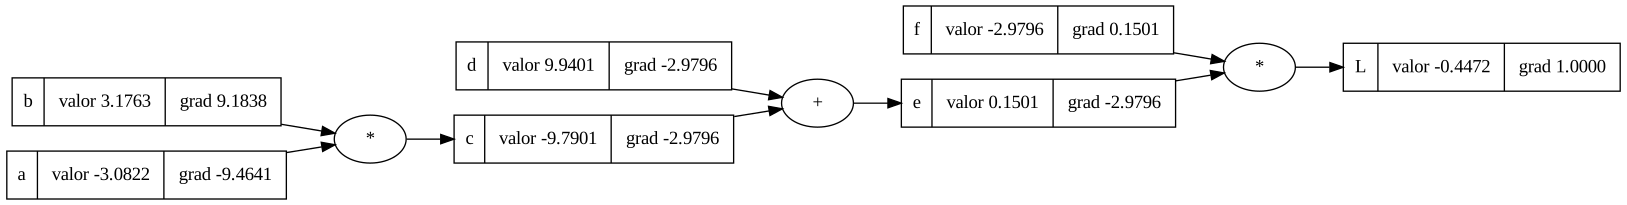
El resultado ahora se aproxima más a 0, que era nuestro objetivo.
Bottomless wonders spring from simple rules, which are repeated without end.
Benoît MandelbrotAnteriormente, construimos una especie de neurona; sin embargo, el poder de una red neuronal consiste en que tiene millones de neuronas, todas optimizando sus valores para darnos el resultado que deseamos (en nuestro ejemplo: 0)13.
A continuación, construiremos una red neuronal llamada «perceptrón multicapa» (Multilayer Perceptron o MLP en inglés) que nos permitirá resolver problemas prácticos. Como ejemplo, la entrenaremos para que identifique sarcasmo en reseñas de películas.
Para detectar sarcasmo en las reseñas que los usuarios dan sobre una película, podríamos tomar como base dos variables: el sentimiento (con valores del 1 al 5, donde 5 es un sentimiento positivo y 1 uno negativo) y la calificación asignada (también con valores del 1 al 5). El resultado tendría que ser 1 para sarcasmo y 0 para ausencia de sarcasmo. Por ejemplo14:
Genial, me encanta cuando veo una película de terror con la típica trama de siempre. Calificación: 2/5.
En este caso, el sentimiento es positivo (utiliza expresiones como «genial», «me encanta»), pero la reseña es negativa, de manera que podemos establecer una relación de proporcionalidad inversa entre ambas variables para detectar el sarcasmo: si la calificación es baja pero el sentimiento «alto», entonces hay sarcasmo (es decir, sarcasmo =1).
import random

class Neurona:
  def __init__(self, nentradas):
    self.peso = [Numero(random.uniform(-1,1)) for i in range(nentradas)]
    self.sesgo = Numero(random.uniform(-1,1))

  def __call__(self, x):
    activacion = sum((peso_i*x_i for peso_i, x_i in zip(self.peso, x)), self.sesgo)
    resultado = activacion.tanh()
    return resultado

  def parametros(self):
    return self.peso + [self.sesgo]
Ahora podemos crear una neurona y visualizar su estructura:
sentimiento = Numero(5.0, etiqueta='sentimiento')
calificacion = Numero(5.0, etiqueta='calificacion')

N = Neurona(2)
neuron = N([sentimiento, calificacion])
neuron.propagar()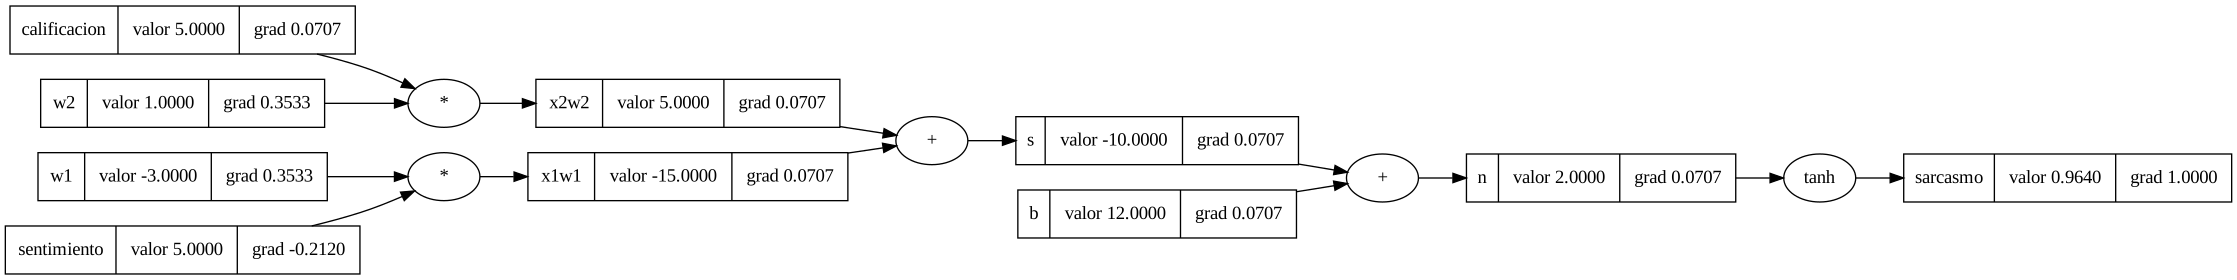
Por el momento, nuestros valores son aleatorios y todo funciona mal. Para optimizar apropiadamente, será mejor crear una arquitectura más robusta con múltiples capas.
Construiremos una «capa», que no es más que una forma programática de definir cuántas neuronas queremos para nuestras entradas, y finalmente conectaremos todo con un «perceptrón multicapa», que consiste en unir varias capas entre sí:
class Capa:
  def __init__(self, nentradas, nsalidas):
    self.neuronas = [Neurona(nentradas) for _ in range(nsalidas)]

  def __call__(self, x):
    resultado = [n(x) for n in self.neuronas]
    return resultado[0] if len(resultado) == 1 else resultado

  def parametros(self):
    return [parametro for n in self.neuronas for parametro in n.parametros()]

class MLP:
  def __init__(self, nentrada, nsalidas):
    tamaño = [nentrada] + nsalidas
    self.capas = [Capa(tamaño[i], tamaño[i+1]) for i in range(len(nsalidas))]

  def __call__(self, x):
    for capa in self.capas:
      x = capa(x)
    return x

  def parametros(self):
    return [parametro for capa in self.capas for parametro in capa.parametros()]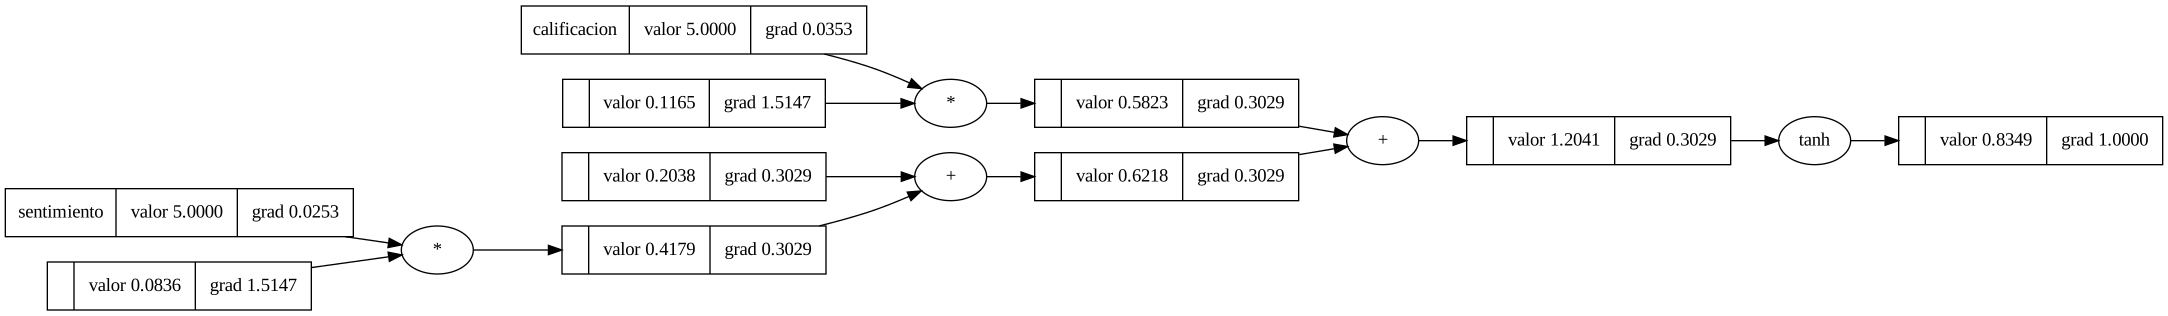
Daremos a nuestro modelo cuatro entradas de entrenamiento (es decir, serán ejemplos para que la red neuronal aprenda): cada entrada tendrá el sentimiento y la calificación asignada, así como el valor de sarcasmo objetivo que deseamos:
RN = MLP(2, [4, 4, 1])

entradas = [
    [5.0, 5.0], # no sarcasmo
    [5.0, 1.0], # sarcasmo
    [5.0, 2.0], # sarcasmo
    [4.0, 5.0], # no sarcasmo
]

objetivos = [0.0, 1.0, 1.0, 0.0]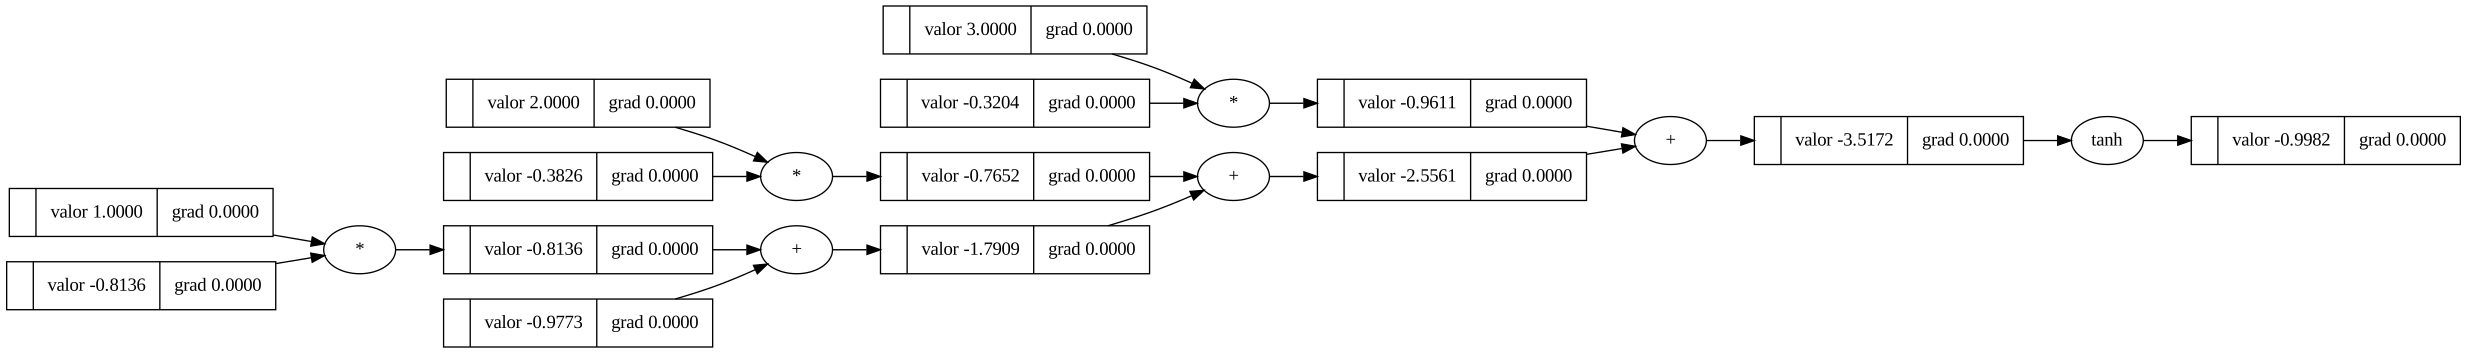
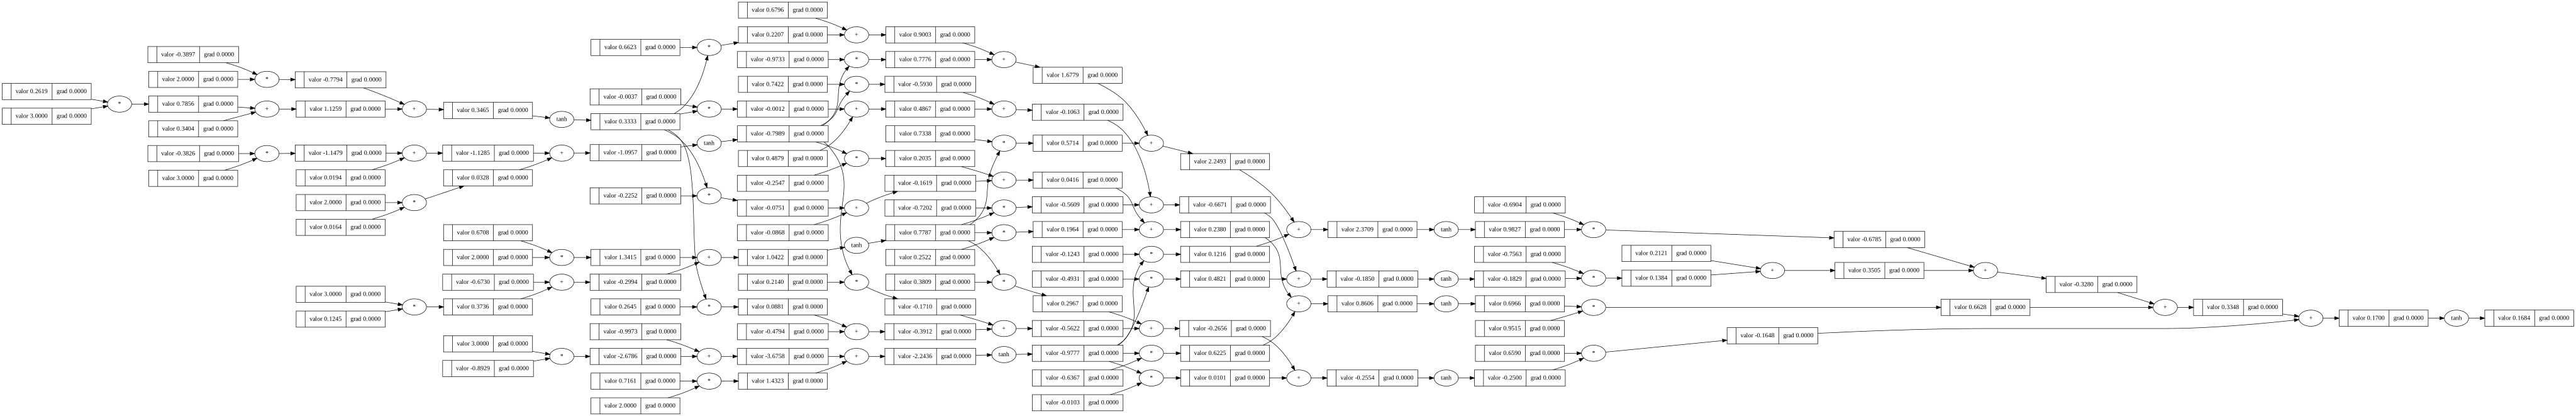
Nuestras predicciones de sarcasmo fueron generadas con valores aleatorios, de manera que todas son erróneas. Ahora, debemos cuantificar qué tan alejadas están de su objetivo. Para ello, crearemos una función que mida la diferencia entre el objetivo y la predicción15. Se trata de una simple resta, pero la elevaremos al cuadrado para obtener solo números positivos:
for k in range(30):
  # paso hacia delante
  preds = [RN(x) for x in entradas]
  perdida = sum([(pred - obj)**2 for pred, obj in zip(preds, objetivos)])

  # propagación hacia atrás
  for p in RN.parametros():
    p.grad = 0.0
  perdida.propagar()

  # actualizar
  for p in RN.parametros():
    p.valor += -0.07 * p.grad

  print(k, perdida.valor)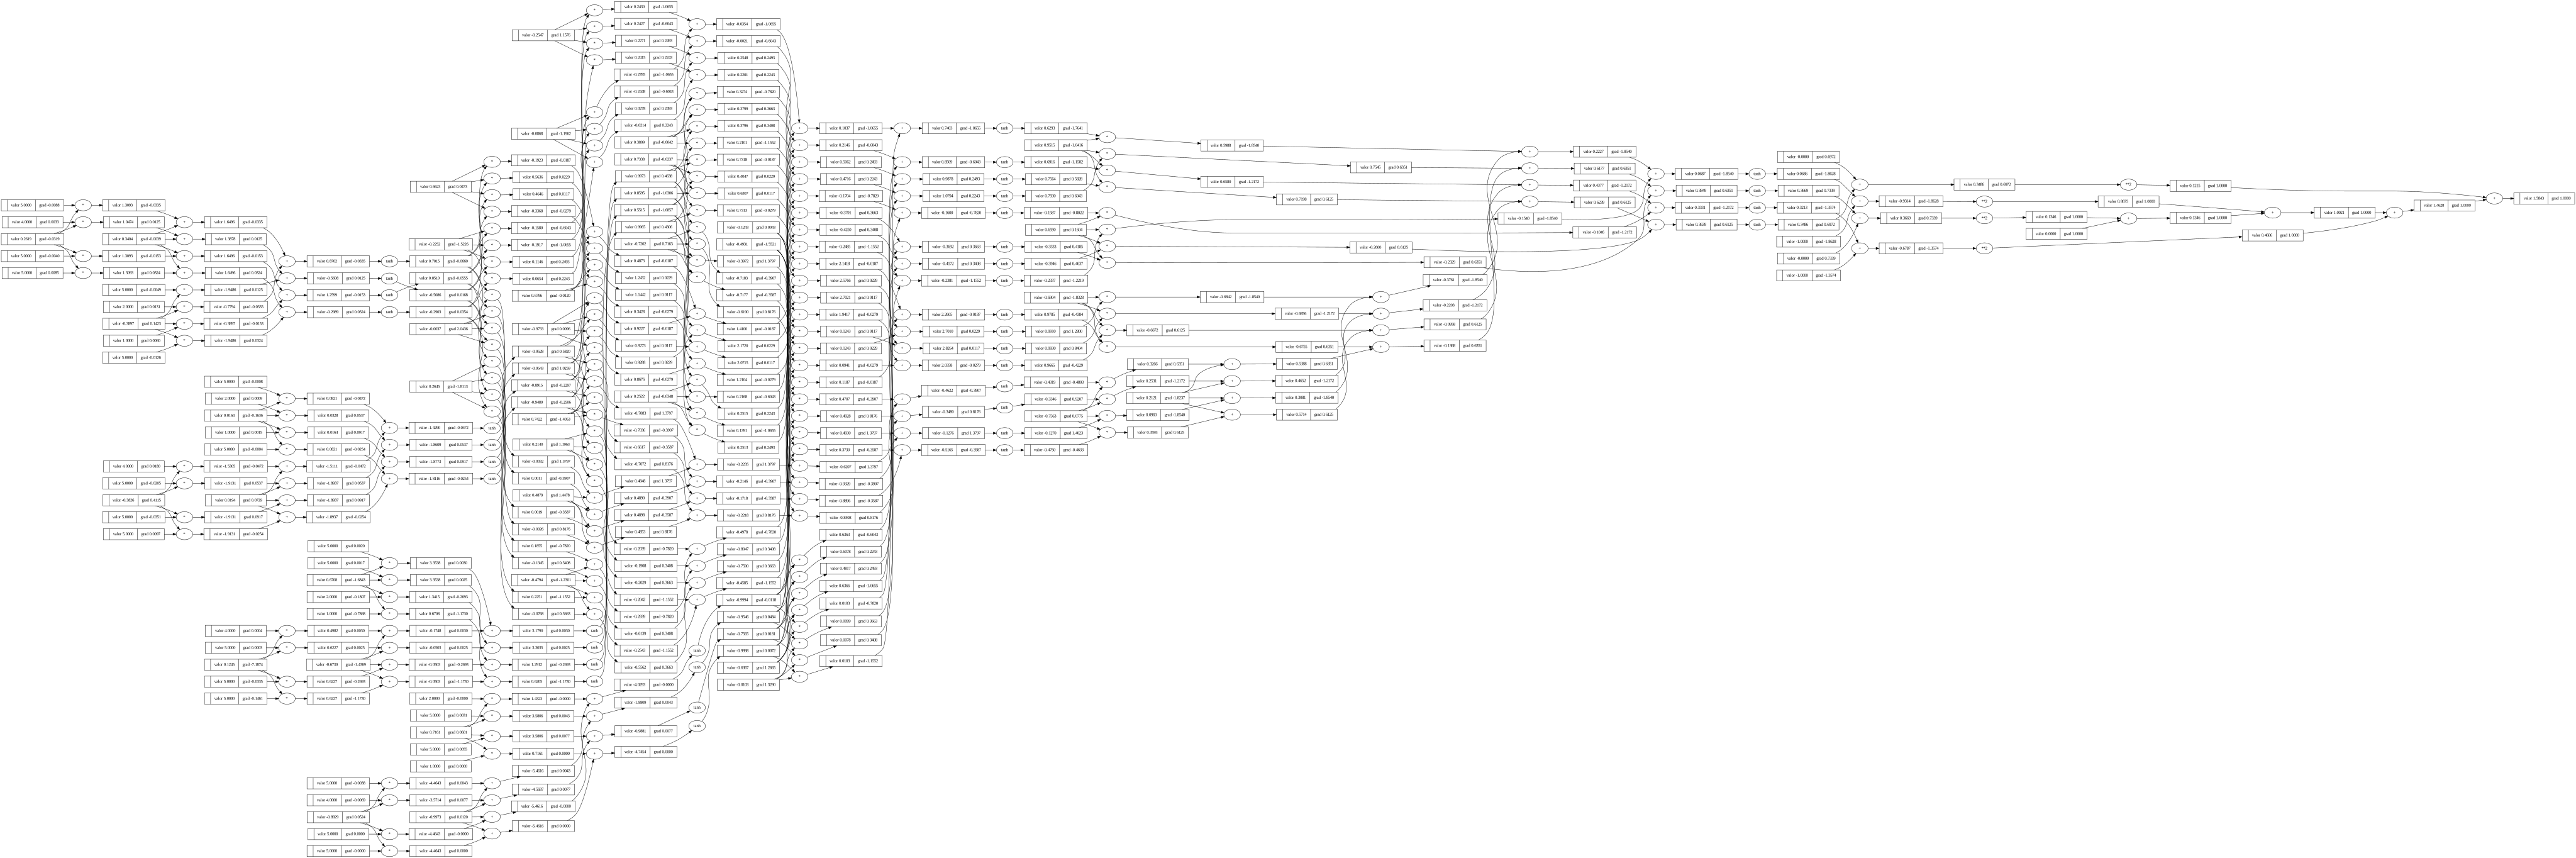
Al entrenar, nuestra función de pérdida disminuyó casi a cero16. Comprobemos que nuestras predicciones ahora sean más similares a nuestros objetivos:
preds~ [≈0.10, ≈0.92, ≈0.90, ≈0.03]objetivos~ [0.0, 1.0, 1.0, 0.0]En efecto, nuestro modelo ya es mucho más apto ahora que antes para detectar sarcasmo. ¿Qué tal si hacemos un test con una nueva calificación? El sentimiento será de 5 y la calificación 1.5:
test = [5.0, 1.5]
prediccion = RN(test)
~ Valor=0.90Nuestra red neuronal considera que existe un \approx90 \% de probabilidad de que sea sarcasmo. Nada mal.
Los símbolos \Delta, \delta son letras del alfabeto griego llamadas «delta», y generalmente se utilizan en matemáticas para representar o leer un cambio: «cambio en y sobre cambio en x».↩︎
La palabra «secante» significa «cortar» en latín (secare), de manera que la línea secante es aquella que corta una figura cuando la toca en dos puntos. Por otro lado, la palabra «tangente» significa «tocar» en latín (tangere), de manera que la tangente es una línea que apenas toca en un punto a otra figura. La palabra «tangible» viene de la misma raíz y de ahí su significado también.↩︎
Tengamos en mente lo siguiente: nuestra función es curva porque su inclinación siempre cambia, y su inclinación siempre cambia porque cada valor de x influye en y de manera distinta. Intuitivamente, cuando x=4, y resulta de 4^2, es decir, y resulta de multiplicar 4 \times 4; pero cuando x=5, y aumenta en una proporción diferente: 5 \times 5. Por contra, las rectas o funciones lineales siempre cambian en la misma proporción —anteriormente, siempre se multiplicaba cada x por 5—, de manera que su inclinación es única y constante.↩︎
Hasta donde sé, fue Leibniz quien inventó la derivada razonando de una manera casi idéntica a la nuestra.↩︎
Sobre límites se puede leer este artículo; sobre derivadas, son recomendables también estos videos.↩︎
Bien vista, la expresión \frac{dy}{dx} ilustra a la perfección el concepto: estamos midiendo la diferencia en el valor de y (dy) que provoca un cambio infinitamente pequeño en la variable x, es decir, una pequeña diferencia —denotada por h— en x: dx. Finalmente, para averiguar la proporción que guardan entre ellos, los dividimos entre sí, midiendo la derivada —diferencia— de y con respecto a x —es decir, con respecto a una pequeña diferencia en el valor de x. El nombre «cálculo diferencial» viene precisamente de la medición de esas pequeñas diferencias en los valores de las variables.↩︎
En la práctica, también es común ver la derivada escrita simplemente como la notación de función prima: f'(x). Esta notación también indica «la tasa de cambio de la función en el punto x».↩︎
En rigor, la derivada no solo se diferencia de la pendiente por referirse a funciones no lineales, sino también porque es útil para medir el impacto que diferentes variables tienen en una función compuesta (es decir, en una función de más de dos dimensiones o variables). Esto lo veremos más adelante, sin embargo, es importante ser conscientes de que nuestra formulación geométrica de la derivada es una manera intuitiva —y legítima en términos históricos— de entenderla, pero su concepto puede ampliarse a problemas, funciones y dimensiones más complejas que son difíciles de visualizar.↩︎
Ojo: disminuir el 3 aumenta el resultado, puesto que está siendo multiplicado por un número negativo. Ejemplo: 3-1 = 2, 2 \times -2 = -4, y -4 es mayor que -6, el resultado inicial.↩︎
El nombre técnico de esta derivada es «derivada parcial», puesto que la función L está compuesta de múltiples variables que, a su vez, están concatenadas entre sí mediante otras funciones (suma y multiplicación). En ese sentido, L es una función compuesta, y deseamos saber la derivada (parcial) de dicha función con respecto a cada variable que la compone o, en otras palabras, queremos determinar de qué forma está influyendo cada variable en el resultado de la función. En síntesis, si tenemos solo una variable en la función, entonces hablamos de derivada; pero si tenemos más de una variable y estimamos la derivada con respecto a cada variable individual, entonces hablamos de derivada parcial. La derivada parcial utiliza la notación \frac{\partial y(x, z)}{\partial x} con una letra «d» cursiva (\partial) para distinguirse. Debemos ser cuidadosos de no confundirla con delta, la «d» griega (\delta).↩︎
Para abundar en la historia de las redes neuronales y el aprendizaje profundo en general, y de la propagación hacia atrás en particular, véase el trabajo de Schmidhuber y el de Yuxi Liu.↩︎
A la derivada global, es decir, a la que se da con respecto al resultado final y no al local, se le denomina «gradiente». Las fórmulas que utilizamos para derivar pueden leerse aquí.↩︎
Esta idea se ha atribuido a Benoît Mandelbrot, quien la formuló en el contexto de la geometría fractal.↩︎
El ejemplo está inspirado en el formulado por Sriraman Madhavan.↩︎
A esta función se le llama «error cuadrático medio» (o mean squared error, MSE en inglés); matemáticamente podemos definirla como \frac{1}{n} \sum_{i=1}^n (y_i - \hat{y}_i)^2. Esta expresión matemática es la «función de pérdida» (loss function) más simple que hay, pues solo estamos haciendo una sumatoria con la resta entre objetivos y predicciones.↩︎
Al proceso de «propagar hacia atrás» las derivadas parciales de cada neurona se le denomina «descenso de gradiente estocástico» (stochastic gradient descent) porque, como decíamos, disminuimos la función de pérdida con base en el gradiente. «Estocástico» significa «aleatorio» y utilizamos este término porque en un inicio nuestros parámetros w, b eran aleatorios.↩︎